エージェントとのチャットは、毎回ゼロから始まります。月曜日、誰かがアシスタントと一緒に 2 つの拠点の実績を確認し、どのフォローアップを誰が担当するかを書き留め、予算のケースを決めます。木曜日に新しいチャットを開いて「N-11 について何を決めましたっけ?」と尋ねても、エージェントは N-11 が何なのか見当もつきません。ユーザーは画面をスクロールして戻り、コピーして貼り付け、また一から説明することになります。
この記事では、そのギャップをごくわずかなコードでどう埋めたかを紹介します。エージェントに渡すツールは recall_my_conversations 1 つだけ。これは現在のユーザー自身の過去のチャットを検索し、日付付きの抜粋を返します。検索エンジンには funes を使いました。自前で書く代わりに再利用した、オープンソースのプロジェクトです。つなぎ役は小さな FastMCP サーバーで、すべてが 1 つのコンテナの中で動きます。
これは、MCP 上でのエージェント向けツール群についてのシリーズの 3 本目です。1 本目は、エージェントが Python を安全に実行できる場所を用意しました。2 本目は、行ではなく参照を渡すことで、大量のデータを会話記録の外に保ちました。今回は、エージェントが会話記録そのものを調べられるようにします。
想起は記憶ではない、そしてそれでいい
「エージェントの記憶」と言うとき、たいていは野心的な何かを指します。会話から事実を抽出し、プロファイルを最新に保ち、矛盾を解消し、適切な文脈を毎回のプロンプトにそっと注入するシステムです。これは作るのも難しく、信頼するのも難しいものです。うまくいかないと、エージェントはあなたが言ってもいないことを「記憶」してしまい、それがどこから来たのか誰にもわかりません。
私たちが欲しかったのは、もっとずっとシンプルなもの、自分のメールを自分で検索する人の動きに近いものでした。
- 過去は、起きたとおりの姿のまま残ります。要約も、書き換えも、統合もしません。
- いつ振り返るかは、ツールを呼び出すエージェント自身が決めます。
- 返ってくるのは日付付きの、そのままの一節です。エージェントはそれを引用でき、ユーザーはそれを確認できます。
- 関係するものが何も見つからなければ、エージェントはそう伝えます。
想起がエージェントに与えるのは、過去へのヒントです。ユーザーのモデルを与えるわけではありません。エージェントは相変わらず毎回ゼロから推論しますが、もう作業までゼロからやり直す必要はありません。先週使ったパラメーター、書き留めた担当者、下された決定を拾い上げられます。ユーザーに繰り返させる代わりに。
これだけで、価値の大部分を、リスクのごく一部で得られることがわかりました。
車輪の再発明はしない:funes
過去のエージェントセッションを検索することは、コーディングエージェントの世界ではすでに解決済みの問題です。Hugging Face の funes は、「過去のエージェントセッションの、永続的で検索可能な記憶」です。Claude Code や Codex などの会話記録をインデックス化し、エージェントが以前の作業を想起できるようにします。(この記事を準備する際にも、私たち自身の過去の記事を探すのに使いました。)
開発者のノート PC だけでなく、プロダクトにもうまくはまる理由は次のとおりです。
- バイナリ 1 つ、サービスなし。 組み込みのストレージエンジン(Lance)を内蔵した、単一の Rust 実行ファイルです。動かすべきデータベースサーバーも、ベクトルサービスも、キューもありません。
- 内部に LLM はない。 検索は 2 つの小さなローカルモデル、bge-small-en-v1.5 の埋め込みモデルと、任意で使う bge-reranker-base のクロスエンコーダーだけで動きます。何もコンテナの外には出ませんし、想起がハルシネーションを起こすこともありません。実在するテキストしか返さないからです。
- 1 つの記憶は 1 つのディレクトリ。
FUNES_HOME=/some/dirが、独立した記憶を与えてくれます。ストレージ層にとってのテナント分離は、ユーザーごとに 1 ディレクトリで十分です。 - 素朴な入力形式。 インデックス化の対象は
.funes.jsonlファイルです。1 メッセージ 1 行で、セッション ID、連番、タイムスタンプ、ロール、テキストブロックを持ちます。どんなチャットシステムでも、これなら作れます。 - エージェント向けの読み出しコマンド群:
recall(ランク付き検索)、get(セッションの範囲を読む)、scan(1 セッション内の完全一致文字列)、sessions、sketch。 - 緩やかなライセンス: funes は Apache-2.0、2 つのモデルはどちらも MIT です。
想起が内部でどう動くか
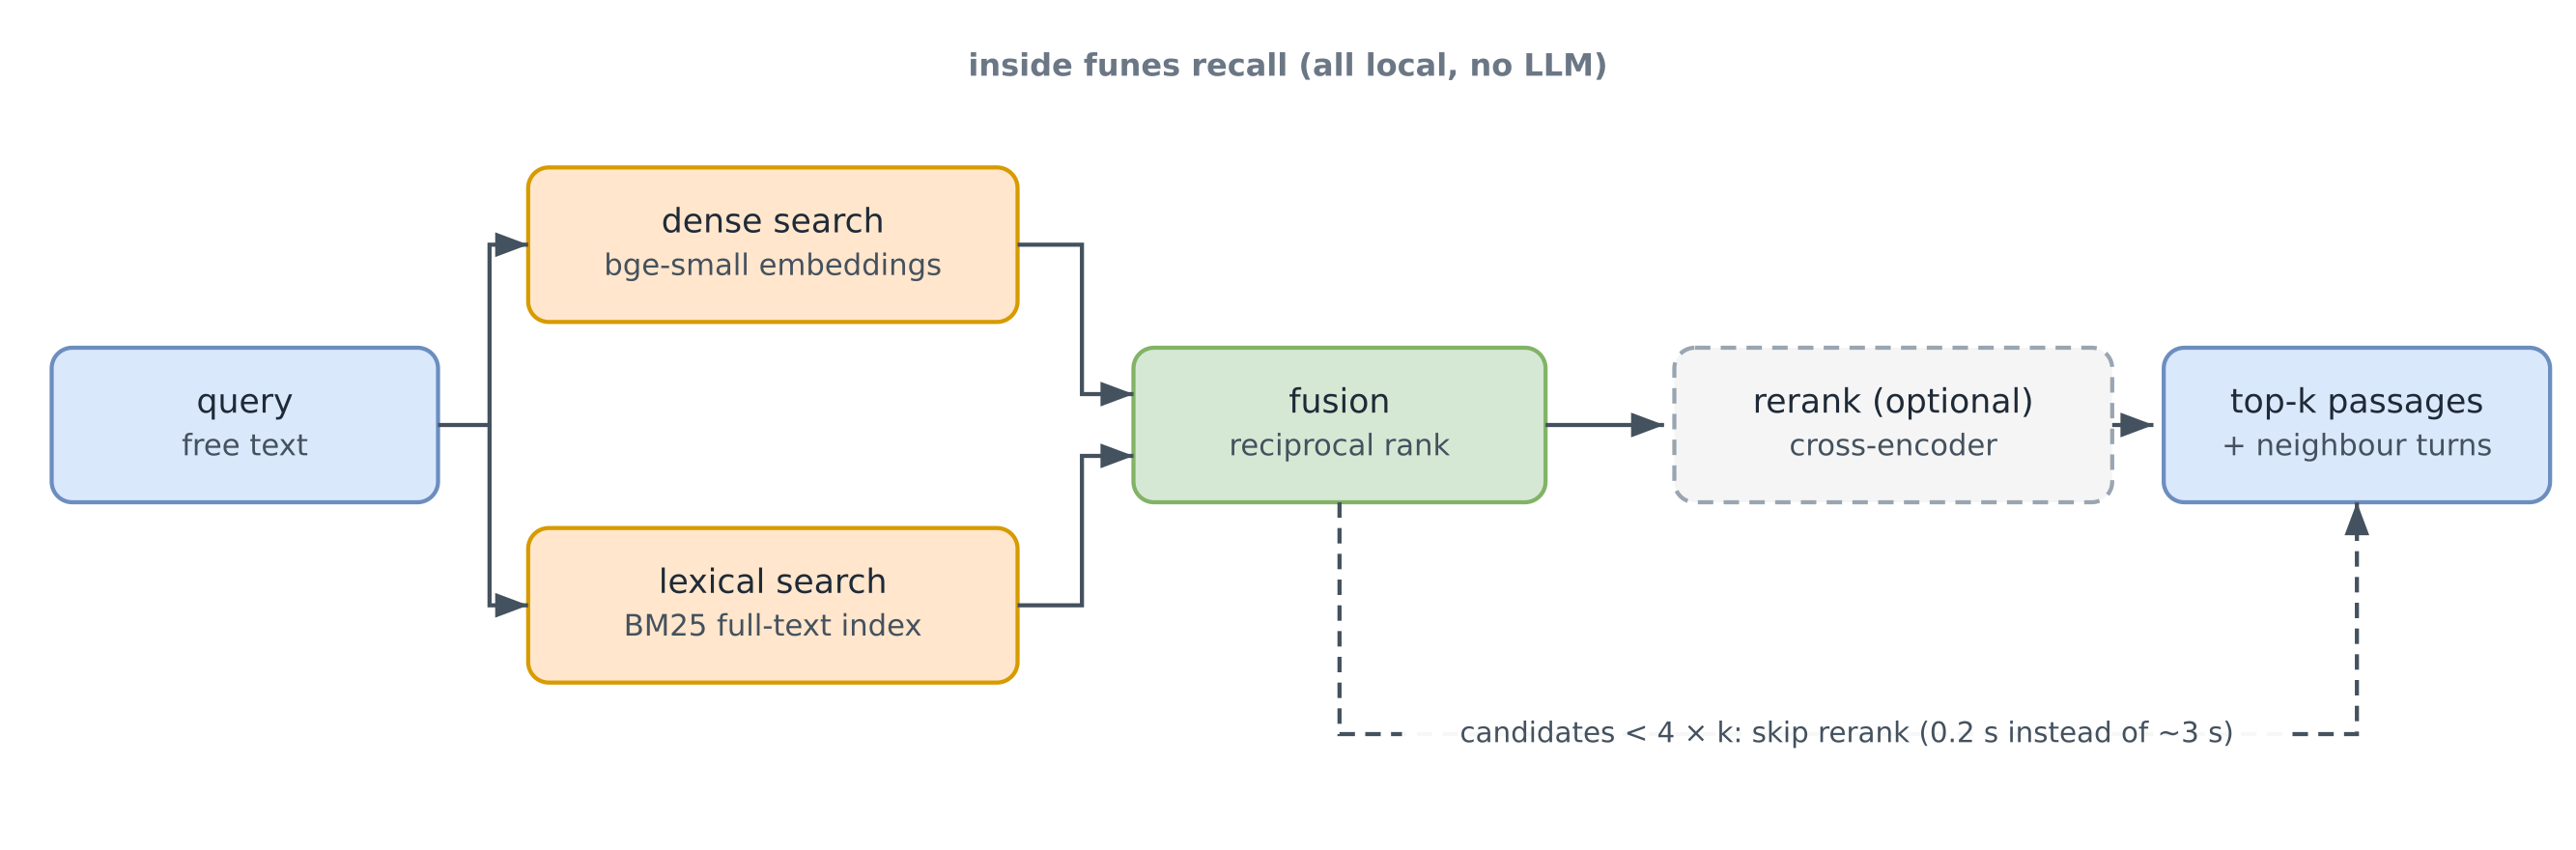
クエリは、2 つの経路を同時に進みます。密ベクトル検索は、似た意味を持つ一節を見つけます(「作業指示」で「チケット」が見つかる、など)。BM25 による全文検索は、MT-4471 や N-11 のような、埋め込みが苦手とする正確なトークンを見つけます。2 つのランク付けされたリストは reciprocal rank fusion で統合され、各ヒットは前後のターンと一緒に返ってくるので、エージェントには答えだけでなく、その答えを導いた質問も見えます。
同じ分裂は、私たちのテーブル名検索の実験でも見られました。密ベクトル検索と字句検索は、それぞれ異なるクエリで失敗します。両者を融合させておくのは、安価な保険です。funes はそれを標準で備えています。
任意で使える 3 段階目は、候補プールを再採点するクロスエンコーダーです。funes は、候補プールが k の 4 倍以上になったときにこれを有効にします。1 回の呼び出しあたり約 3 秒、1.6 GB の RAM がかかります(数値は後述)。会話の想起ではこれをオフにしています。プールは 4 × k を下回ったままにし、最初の試みが外れたときは、エージェントが別の言葉で聞き直すことで補います。
アーキテクチャ
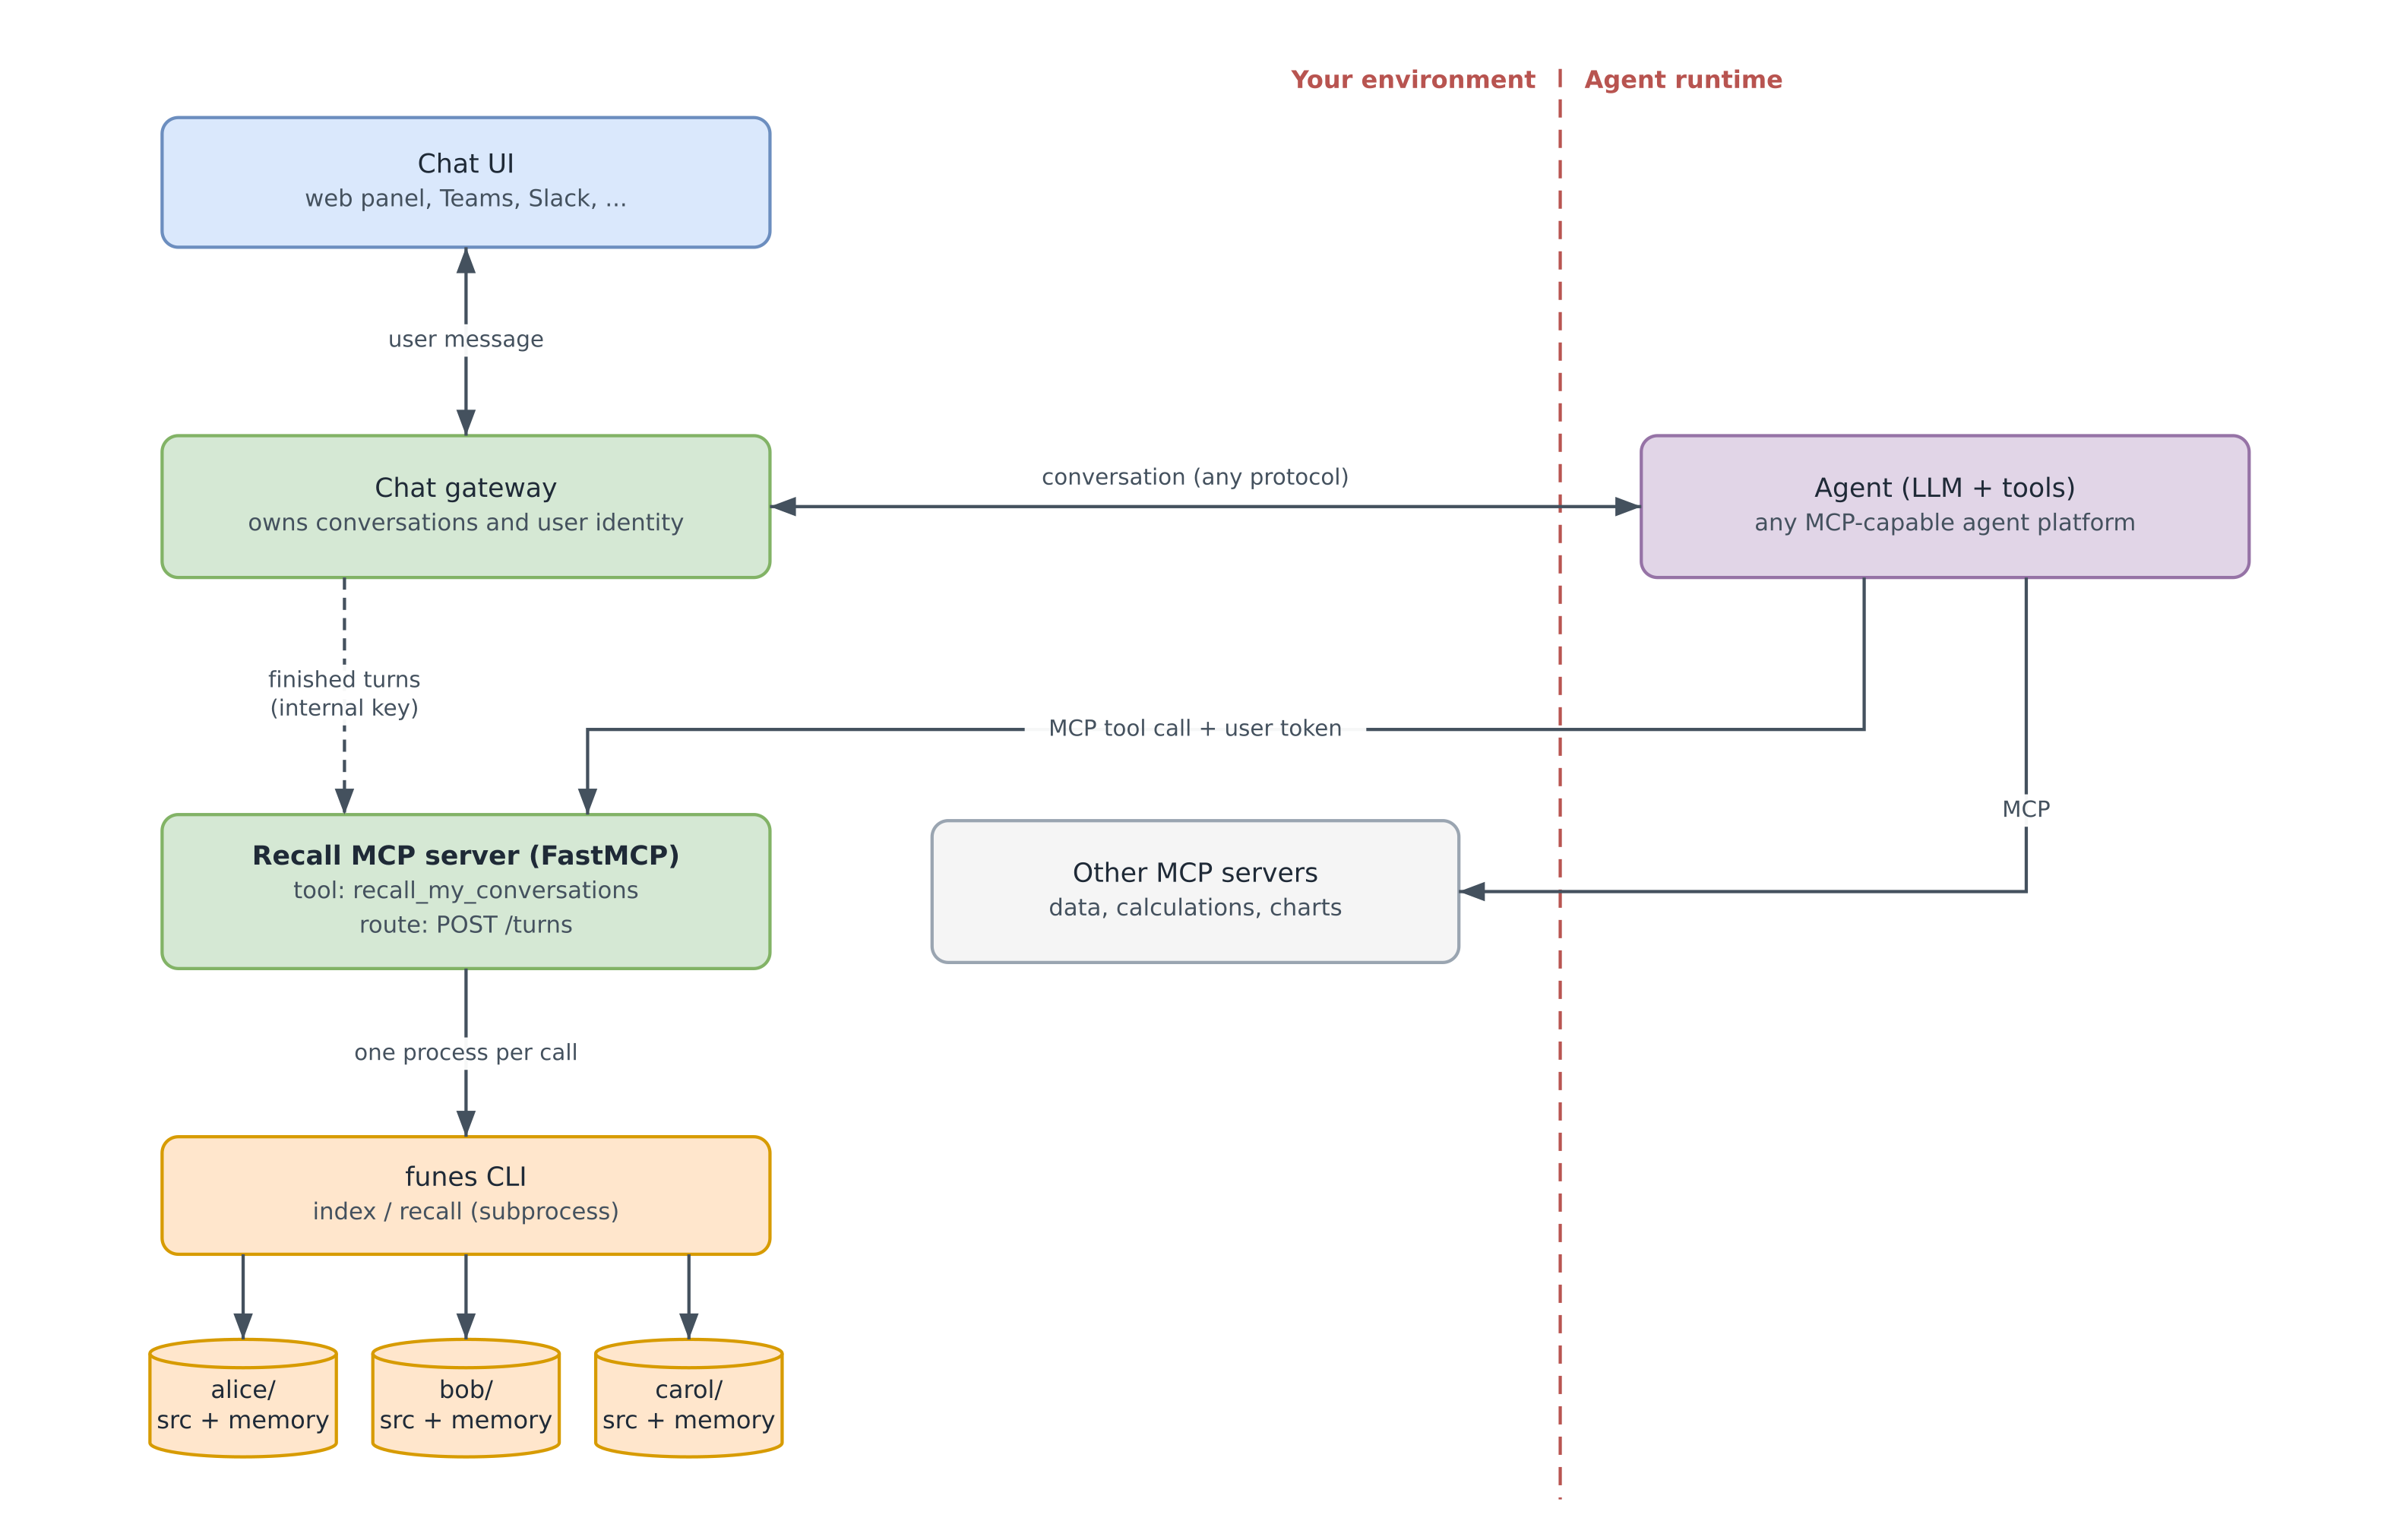
パスは 2 つあり、意図的に異なる認証情報を使い分けています。
- 書き込みパス(破線)。 チャットゲートウェイはもともとすべてのメッセージを見ているので、完了した各ターンを、共有鍵で保護された内部ルート経由で想起サーバーに転送します。エージェントプラットフォームはここに関与しません。記憶に書き込むことはできず、プロンプトインジェクションが「記憶」を植え付けることもできません。
- 読み出しパス。 エージェントは、他の MCP ツールと同じように
recall_my_conversationsを呼び出します。サーバーは呼び出し元のトークンからユーザーを特定し、そのユーザーのディレクトリだけを検索します。誰の記憶を検索するかを、クエリのテキストが決めることは決してありません。
エージェントプラットフォームは、MCP を話せるものなら何でも構いません。最初は、商用のエージェントプラットフォーム上で動く本番のコパイロットの中に、Java 製の MCP サーバーとしてこれを組み込みました。以下のデモは、同じ設計を Python だけで自己完結させたバージョンです。
書き込みパス:完了したターンを転送する
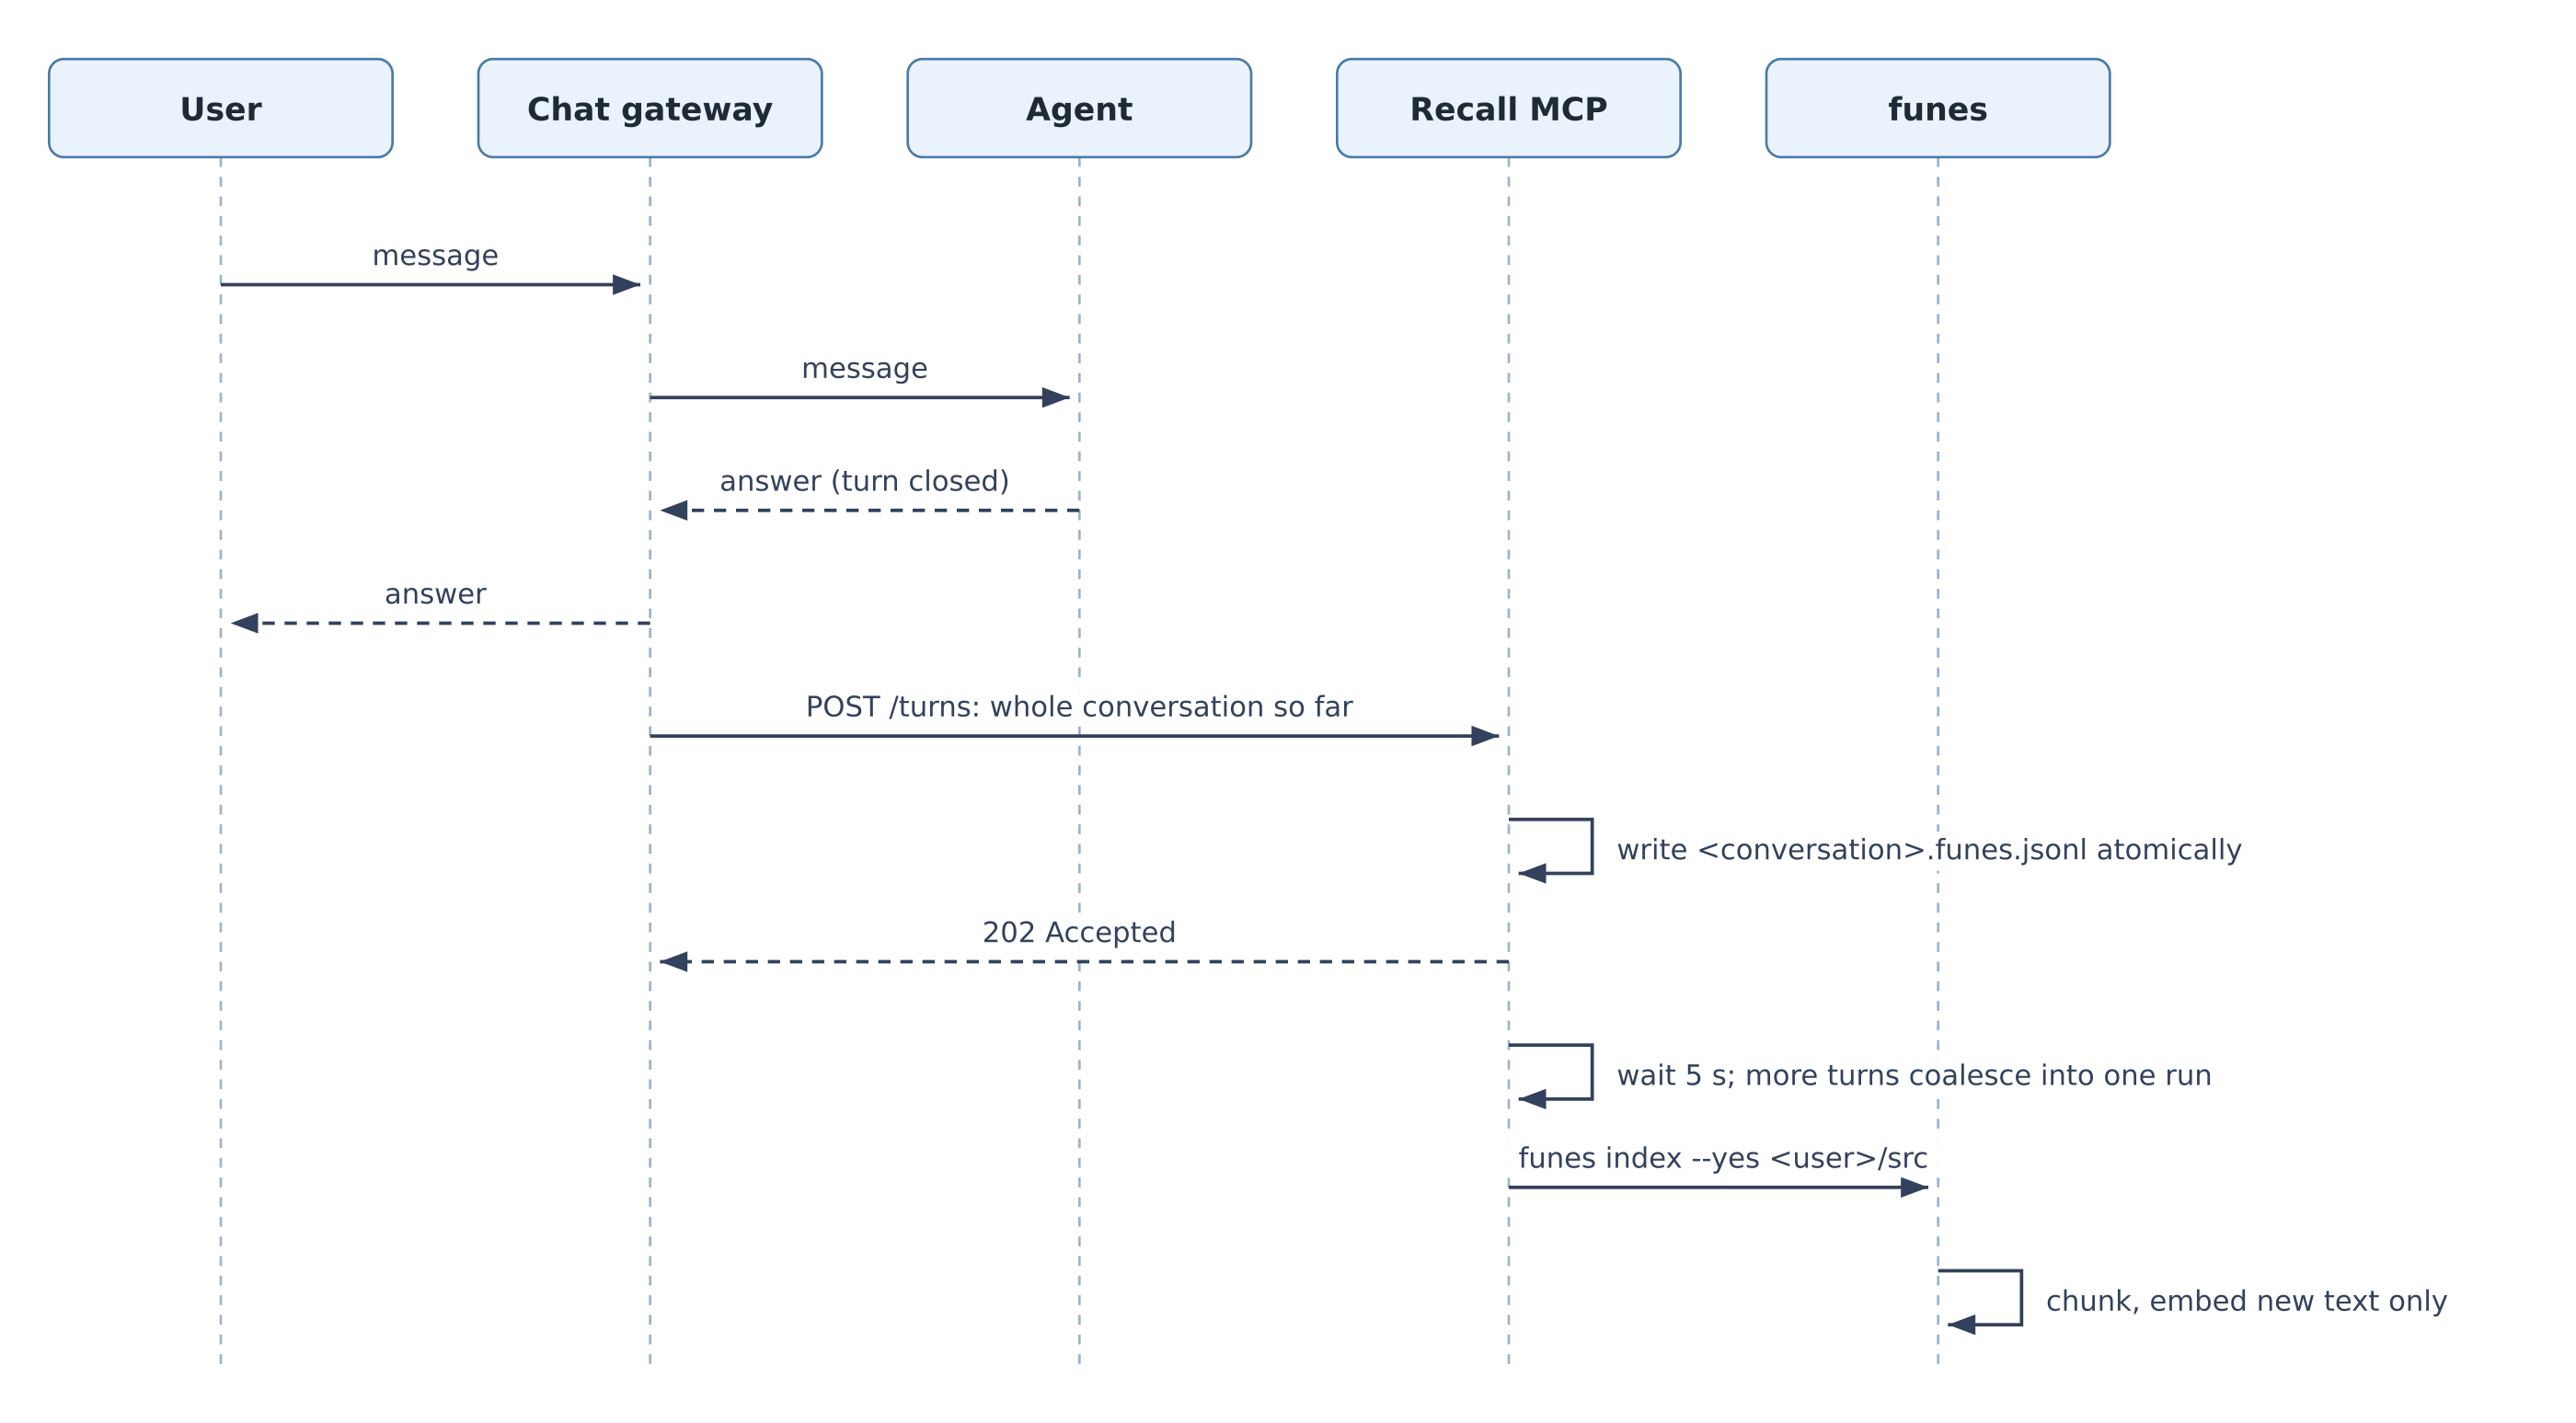
ゲートウェイは、各ターンの後にそれまでの会話全体を送信します。無駄に聞こえるかもしれませんが、これによって書き込みが冪等になります。サーバーは会話ごとに 1 つのファイルをアトミックに書き換え、すでに埋め込み済みのものを把握している funes は、新しいテキストだけを処理します。
@mcp.custom_route("/turns", methods=["POST"])
async def ingest(request: Request) -> JSONResponse:
    if not hmac.compare_digest(request.headers.get("x-ingest-key", ""), INGEST_KEY):
        return JSONResponse({"error": "unauthorized"}, status_code=401)
    body = await request.json()
    user, cid = body.get("user"), body.get("conversation_id", "")
    if not user or not re.fullmatch(r"[A-Za-z0-9_-]{1,128}", cid):
        return JSONResponse({"error": "user and a safe conversation_id are required"}, status_code=400)
    payload = to_funes_jsonl(cid, body.get("turns", []))

    src = home(user) / "src"
    src.mkdir(parents=True, exist_ok=True)
    tmp = src / f".{cid}.tmp"
    tmp.write_text(payload)
    tmp.replace(src / f"{cid}.funes.jsonl")   # atomic: recall never sees half a file
    schedule_index(user)
    return JSONResponse({"stored": cid}, status_code=202)
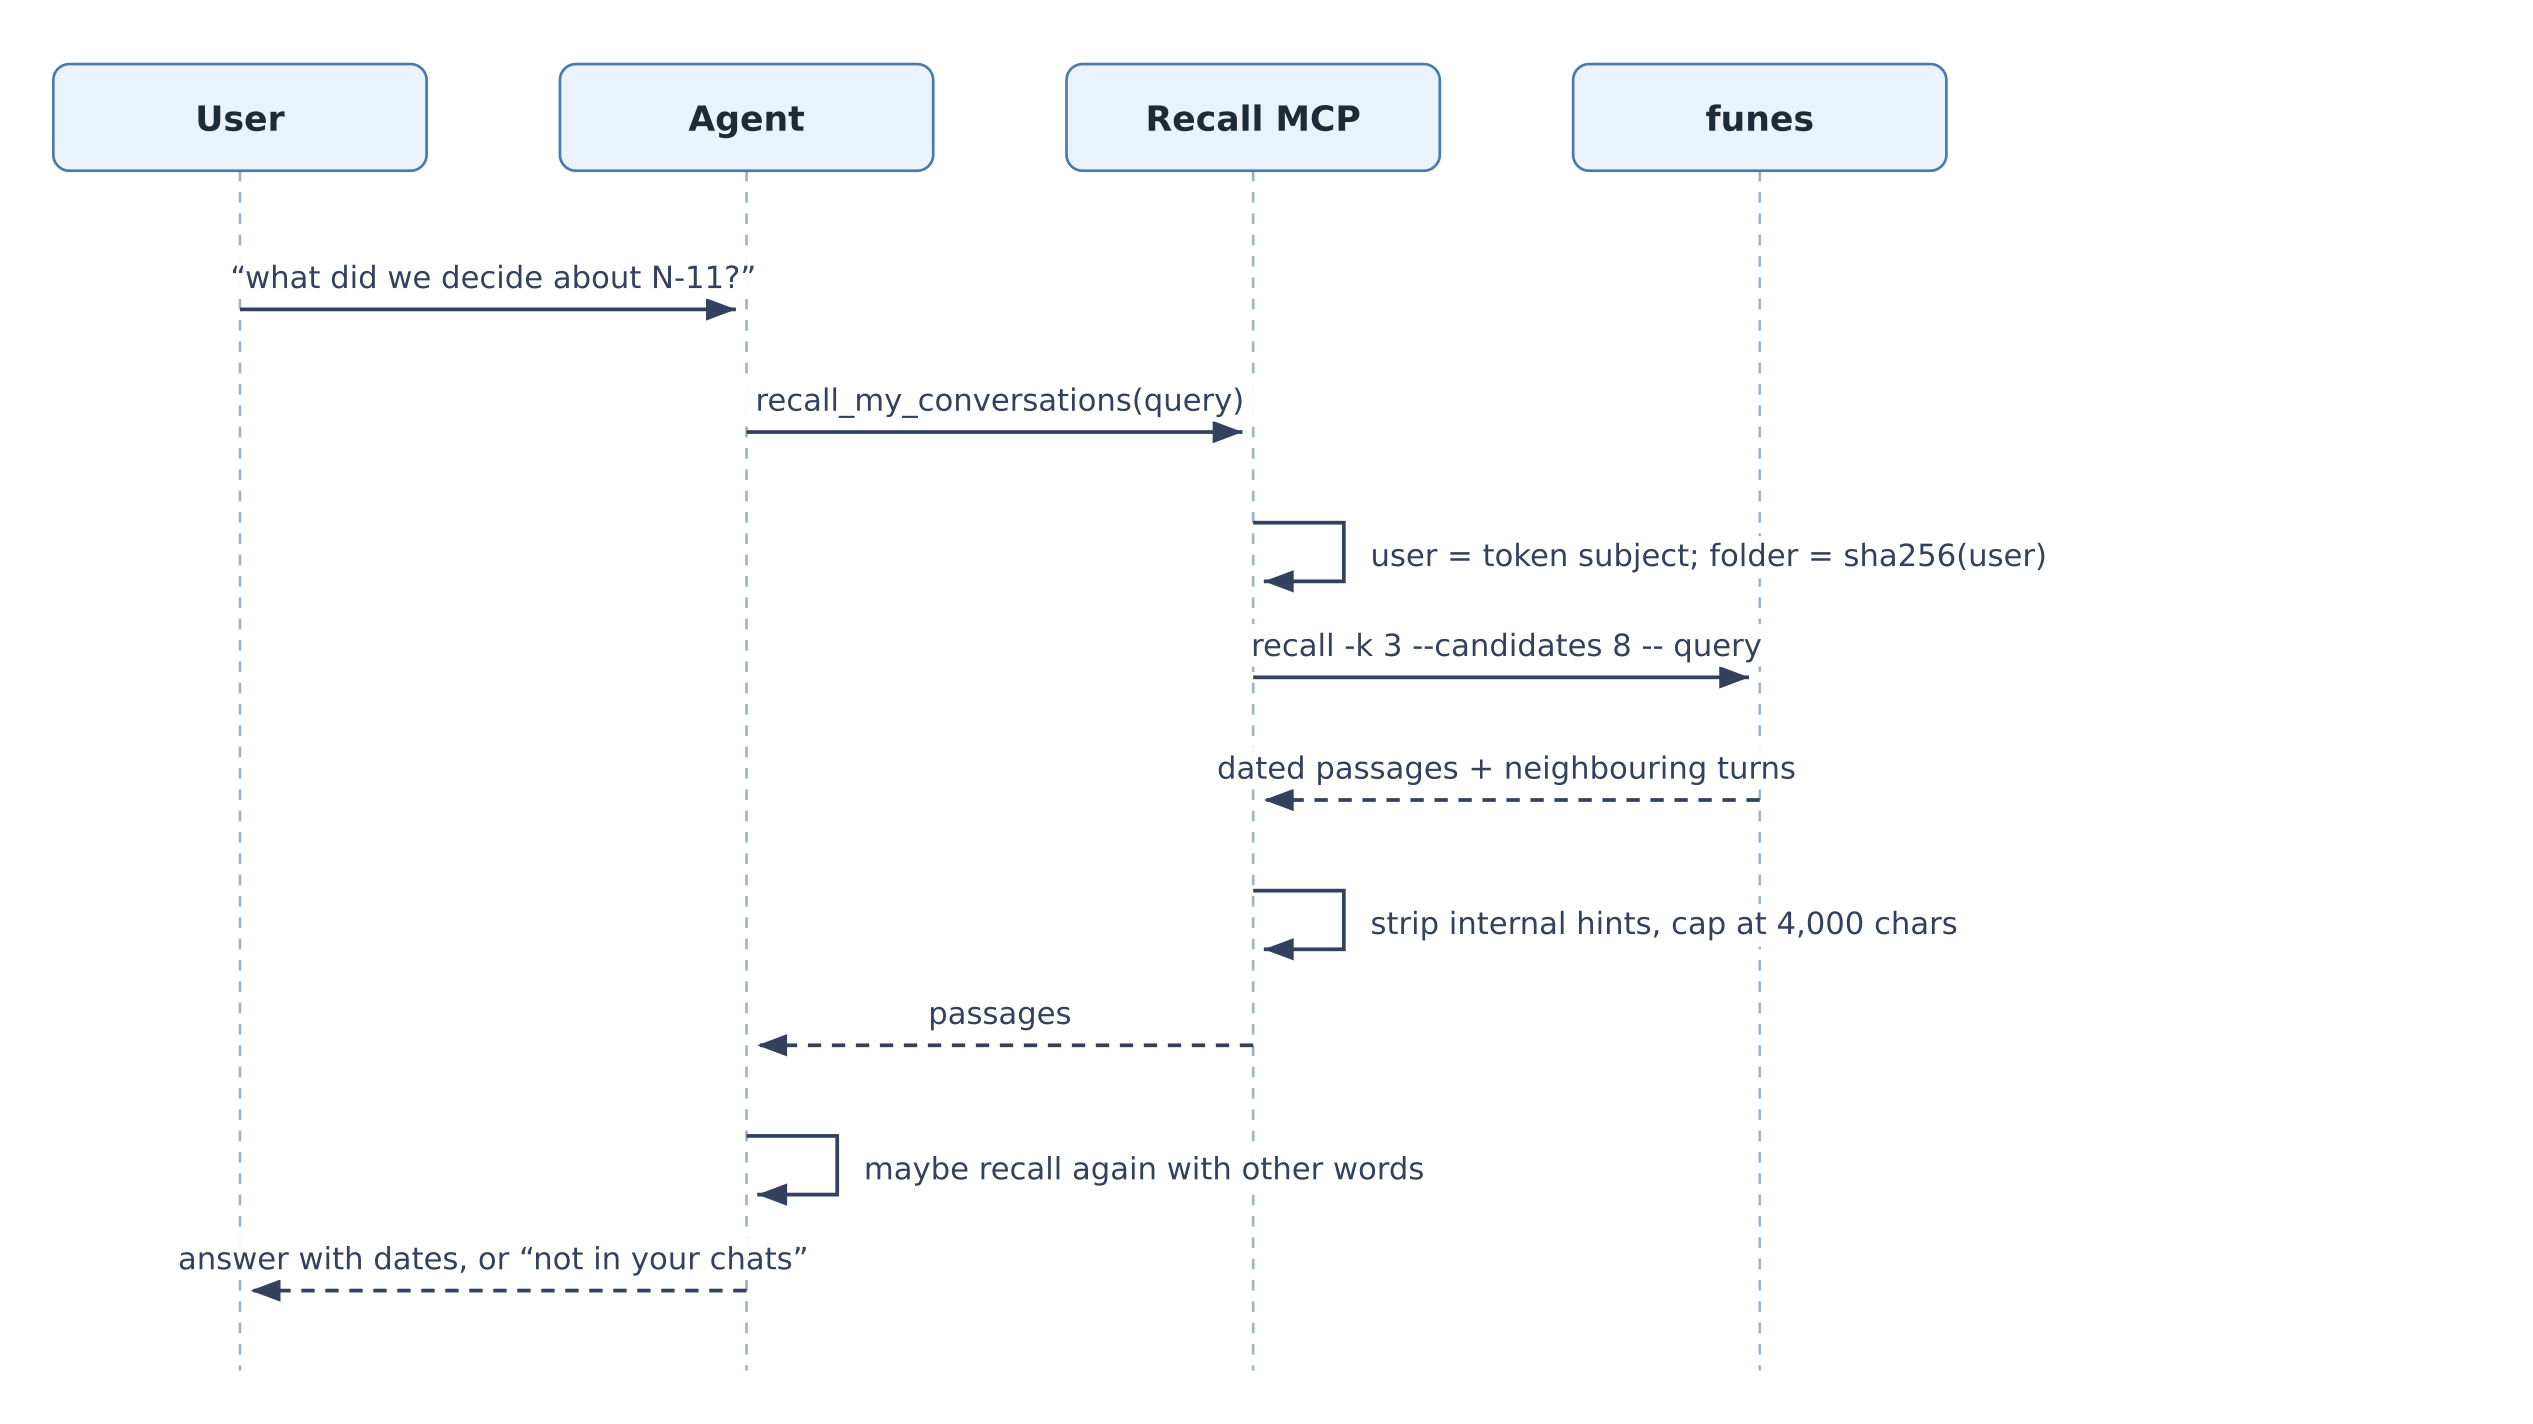
home(user) は DATA / sha256(user)[:24] なので、ディレクトリ名からユーザー ID はわかりません。funes の形式への変換は、数行で済みます。
def to_funes_jsonl(conversation_id: str, turns: list[dict]) -> str:
    lines = []
    for seq, t in enumerate(turns):
        ts = datetime.fromisoformat(t["ts"].replace("Z", "+00:00")).astimezone(timezone.utc)
        lines.append(json.dumps({
            "session_id": conversation_id, "turn_uuid": t.get("id") or f"{conversation_id}-{seq}",
            "seq": seq, "ts": ts.strftime("%Y-%m-%dT%H:%M:%SZ"), "role": t["role"],
            "harness": "copilot", "blocks": [{"block_type": "text", "text": t["text"]}],
        }))
    return "\n".join(lines) + "\n"
インデックス化はユーザーごとにデバウンスされます。ターンがまとめて来ても funes index の実行は 1 回だけで、同じディレクトリに対して 2 つの実行が同時に走ることはありません。実行中に届いた書き込みは、もう 1 回分だけ追加で実行を予約します。
def schedule_index(user: str) -> None:
    st = index_state.setdefault(user, {"task": None, "dirty": False})
    st["dirty"] = True
    if st["task"] is None or st["task"].done():
        st["task"] = asyncio.create_task(index_loop(user))

async def index_loop(user: str) -> None:
    st = index_state[user]
    while st["dirty"]:
        await asyncio.sleep(INDEX_DEBOUNCE)
        st["dirty"] = False
        await funes(user, "index", "--yes", str(home(user) / "src"), timeout=300)
想起はインデックス化を待ちません。ターンが閉じてから数秒後には検索できるようになります。「今何て言った?」を検索ツールに尋ねる人はいないので、これで十分です。
読み出しパス:ツール 1 つ
@mcp.tool
async def recall_my_conversations(query: str) -> str:
    """Search the current user's own earlier conversations with this assistant.
    Use it when the user refers to something discussed before ("last time", "earlier",
    "what did we decide", "the numbers we used"). Use short queries built around identifiers
    and key nouns ("K-2 machine ticket"); search again with other words if needed.
    Returns dated passages from past chats. Quote them; do not invent details."""
    user = get_access_token().client_id          # from the verified token, never from the query
    if not (home(user) / "memory").exists():
        return "No earlier conversations are stored for this user yet."
    async with recall_slots:
        code, out = await funes(user, "recall", "-k", str(RECALL_K),
                                "--candidates", str(RECALL_CANDIDATES), "--", query[:500],
                                timeout=RECALL_TIMEOUT)
    if code != 0:
        return "Conversation memory is unavailable right now; continue without it."
    out = HINT_LINE.sub("", out).strip()         # drop funes' "→ get <session> --memory <path>" hints
    return out[:MAX_RESULT_CHARS] or "Nothing relevant found in earlier conversations."
見た目以上に効いている細部がいくつかあります。
- docstring が、呼び出しの引き金であり説明書でもある。 エージェントは、説明文がユーザーの言い回しと合ったときにツールを呼び出します。「前回」「以前」「何を決めたっけ」は、人が実際に使う言葉です。説明文にはクエリの書き方も書いてあります。短く、識別子を中心にしたクエリの方がうまくランク付けされるからです(測定結果を参照)。
- クエリの前の
--。-k 100と入力したユーザーは、そのテキストを検索したいのであって、フラグを渡したいわけではありません。 - ヒント行は取り除く。 funes は各ヒットの後に
→ get <session> --memory <path>を表示します。getを呼べるエージェント向けですが、こちらのエージェントは呼べません。放っておくと、サーバーのパスやセッション ID が答えに漏れるだけです。最初の試行でまさにこれが起き、エージェントが会話 ID の先頭部分を引用し始めました。 - やわらかく失敗する。 記憶の問題が会話を壊すことは、絶対にあってはなりません。ツールは記憶が使えないと伝え、エージェントはそのまま続けます。
- コストに上限を設ける。 同時実行は最大 4 件の想起、タイムアウトは 10 秒、コンテキストに入る文字数は 4,000 文字が上限です。
funes の呼び出し自体は、環境をクリアした状態で実行されます。FUNES_HOME はユーザーのディレクトリに設定し、HF_HUB_OFFLINE=1 を立て、モデルはイメージに焼き込まれたディレクトリから読み込みます。
パッケージング:コンテナ 1 つ
FROM python:3.12-slim

ARG FUNES_VERSION=1.8.0
ARG FUNES_SHA256=3c7eacbaa4487d253f8e13ef7223325ba05069fc258533db6e19bb5765181fea
ADD --checksum=sha256:${FUNES_SHA256} --chmod=0755 \
    https://github.com/huggingface/funes/releases/download/v${FUNES_VERSION}/funes-x86_64-linux /usr/local/bin/funes

# Bake the embedder: a throwaway index + recall downloads exactly what funes needs.
ARG BAKE_RERANKER=0
ENV HF_HOME=/opt/hf
RUN mkdir -p /tmp/warm/src \
 && echo '{"session_id":"warm","turn_uuid":"t0","seq":0,"ts":"2026-01-01T00:00:00Z","role":"user","harness":"copilot","blocks":[{"block_type":"text","text":"warm up"}]}' > /tmp/warm/src/w.funes.jsonl \
 && FUNES_HOME=/tmp/warm/home funes index --yes /tmp/warm/src \
 && FUNES_HOME=/tmp/warm/home funes recall -k 1 --candidates 2 warm \
 && if [ "$BAKE_RERANKER" = 1 ]; then FUNES_HOME=/tmp/warm/home funes recall -k 1 --candidates 8 warm; fi \
 && rm -rf /tmp/warm && chmod -R a+rX /opt/hf

RUN pip install --no-cache-dir fastmcp==4.1.0
WORKDIR /app
COPY recall_server.py .
RUN useradd -u 10001 -m app && mkdir -p /data/memories && chown app /data/memories
USER app
ENV HF_HUB_OFFLINE=1
CMD ["python", "recall_server.py"]
services:
  recall-mcp:
    build: .
    ports: ["8000:8000"]
    environment:
      INGEST_KEY: ${INGEST_KEY:-demo-ingest-key}
      RECALL_K: "3"
      RECALL_CANDIDATES: "8"
    volumes:
      - memories:/data/memories
volumes:
  memories:
真似する価値があるのは、ウォームアップのステップです。モデルファイルをハードコードする代わりに、ビルドの中で小さなインデックス化と想起を 1 回ずつ実行し、funes が実際に使うモデルだけを HF_HOME にダウンロードさせます。実行時、コンテナは Hugging Face Hub に一切アクセスしません。イメージのレイヤーサイズは、funes のバイナリが 218 MB、埋め込みモデルが 134 MB、FastMCP が 119 MB です。リランカーを焼き込むとさらに 1.13 GB 増えます。これもオフにしておく理由の 1 つです。RUN chmod を別に走らせると 218 MB のバイナリが 2 つ目のレイヤーにコピーされてしまうので、ADD --chmod を使ってください。
うまくいくのか? ある運用リーダーの 2 週間
記憶には、いくつかの拠点を運用する人が 2 週間のうちに交わしていそうな、6 件の会話を種として入れました。2 拠点の実績レビュー、予算のための予測計算、夜間バッチの健全性チェック、引き継ぎ、単位換算の計算、キャパシティチェックです。これらの例は架空のもので、意図的に汎用的にしてあります。ID、担当者、チケット、数字さえあれば、どんな領域でも想起にとっては同じに見えます。2 人目のユーザー bob には、別の拠点についての会話を 1 件与えました。シーダーはチャットゲートウェイの役を演じ、本番とまったく同じように、各ターンの後に会話を送信します。
エージェントには、ヘッドレスモードの Claude を使いました。このサーバーを唯一のツールとして与え、ドメインについての他の知識は一切持たせていません。
claude -p "$QUESTION" --strict-mcp-config --mcp-config mcp-alice.json \
  --tools "" --allowedTools mcp__recall__recall_my_conversations \
  --system-prompt "$(cat system.md)"
以下の回答はすべて、エージェントが想起した一節だけから作り出したものです。
2 つのチャットにまたがる決定とそのブロッカー。 「N-11 のアップグレードについて何を決めた? スケジュールを組む前に何が終わっている必要がある? メモによれば、そのブロッカーはまだ未解決?」 エージェントは 4 回の想起呼び出し(N-11 upgrade、N-11 blocker schedule、MT-4471 K-2 machine、K-2 closed)を行い、こう答えました。
決定(2026-10-08): N-11 のアップグレード案を進めることに決めました。負荷 91% は「許容範囲だがぎりぎり」とのことでした。アップグレード後の North 仕上げラインの想定負荷は、2,400 台/日のうち約 2,185 台/日(91%)です。 スケジュールを組む前に: 保守チケット MT-4471(K-2 マシンの問題)を先に解決する必要があります。 ブロッカーはまだ未解決? 私のメモには解決したとは書かれていません。[…]2026-10-08 以降、MT-4471 が解決・クローズされたという記録は見当たりません。[…]スケジュールを組む前に、保守システムでチケットを確認してください。
決定は 10-08 のチャットから、チケットの詳細は 10-03 の引き継ぎから来ています。エージェントはそれらを結び付け、メモに書かれていないことについては正直でした。
2 つのチャットにまたがって見つかった原因。 「9 月末に照合用の列が空だったのはなぜ? 誰にエスカレーションした?」 あるチャットで、ユーザーは列が空であることに気づき、Tomas に聞くつもりだと書いていました。別の、後のチャットでは、2 件のジョブ失敗がデータフィード F-204 に起因することが判明していました。2 回の想起呼び出しで、エージェントはそれらを結び付けました。ジョブが失敗したのは F-204 フィードの欠落が原因で、問題は統合担当リーダーの Priya に渡っていた、と。さらに、チャットに記録されているのはエスカレーションするつもりだったという点だけで、2 件のジョブ失敗(09-26 以降)は 09-23 から 09-25 までの空白を説明しないとも付け加えました。想起されたテキストでは、正確なエラーメッセージが途中で切れているとも述べています。これは事実です。funes は前後のターンを短いプレビューとして返すので、エージェントは空白を埋めるのではなく、そう正直に言ったのです。
チャットをまたいだ To Do リスト。 「これまでの全チャットから、未対応のフォローアップを 1 つのリストにまとめて」 5 回の想起呼び出しから、5 件の異なるチャットにまたがる 7 件の項目が得られ、それぞれに担当者、期限、出典の日付が付いていました。エージェントは今日の日付と照らして期限超過のものにフラグを立て、2 件が根本的には同じ問題であることを指摘し、曜日から日付に変換した箇所には印を付けて(「チャットには『木曜日』としか書かれていません」)ユーザーが確認できるようにしました。
正確な数値。 「ベースケースとして選んだ予測ケースはどれ? パラメーターは? 18 か月時点の値は?」 双曲線型、q0 は 1,500 台/日、Di は 0.25/年、b は 0.6 で、18 か月時点では 1,069.5 台/日・693.3 千台、比較用に指数型ケースも添えられていました。数値は元の計算と完全に一致しており、エージェントは、チャットには決定は記録されているがその理由は記録されていない、とも付け加えました。
ネガティブコントロールと分離。 「モーター P-7 やチケット MT-5120 について話したことある?」 alice として尋ねると:「いいえ。検索できる過去のチャットには、モーター P-7 やチケット MT-5120 に関するものはありません。」取り違えの可能性があるものとして、最も近いヒット(マシン K-2、チケット MT-4471)を挙げました。bob として同じ質問をすると、P-7 のベアリング異音とチケット MT-5120 について書かれた、South ハブについての彼のチャットが返ってきました。言葉が完全に一致していても、alice には bob の履歴は見えません。alice のトークンが開くのは、常に alice 自身のディレクトリだけだからです。
エージェントの実行は、端から端まで 4〜11 秒、想起呼び出しは 1 回あたり 2〜5 回でした。そのうち想起にかかる時間は、合計で約 1 秒です。完全な回答は examples/agent-runs.md にあります。
本番に近いスタックでも同じ結果
このデモを書く前に、同じ設計を実際のコパイロットに組み込みました。商用のエージェントプラットフォーム、自前のチャットゲートウェイ、Java 製の MCP サーバー、そして同じコンテナの中の funes です。4 件の作業チャット(データ照会、計算、引き継ぎメモ)の後、新しい会話の中で 4 件の想起チャットを行いました。エージェントは 13 回想起呼び出しを行いました。想起された事実はすべて正しく、想起したパラメーターからより長い期間の予算ケースを再計算したものや、一度も話題に出ていない設備についてのネガティブコントロールも含まれていました。想起された詳細の 1 つは、テストドライバーがストリームを途中で諦めた回答に由来するものでした。それでもゲートウェイは完了したターンを転送しており、記憶はテストハーネスよりも多くを知っていたのです。
測定結果
選りすぐった例だけで終わらせないために、1 人のユーザー分の合成履歴を生成しました。6 メッセージからなる会話を N 件、それぞれに確認可能な事実(チケット番号、品質検査の不合格率、タスクの担当者、決定への参照のいずれか)を 1 つ、雑談の中に紛れ込ませています。紛らわしい要素は意図的に仕込んであります。どの拠点・設備も、約 6 件の会話に(雑談の中や、他の事実の一部として)登場し、同じ 12 人の人物、タスクの種類、症状があちこちで繰り返し出てくるので、クエリは組み合わせに一致する必要があり、1 つの珍しい単語には頼れません。各質問の正解はちょうど 1 つです。質問は言い換えてあります。事実としては「チケット MT-1040 がオープンしている」と書かれていても、質問は「ポンプ P-003 のシール漏れについて起票された作業指示の番号は?」のように尋ねます。ヒットとは、期待される答えが、ツールが返すテキストの中に現れることを指します。
すべて、4 CPU・4 GB に制限したコンテナの中で、呼び出しごとに新しい funes プロセスを 1 つ起動して実行しました。サーバーが実際に動かすのとまったく同じやり方です。
| 1,000 件 | 3,000 件 | 10,000 件 | |
|---|---|---|---|
| メッセージ数 / 生テキスト量 | 6,000 / 1.5 MB | 18,000 / 4.5 MB | 60,000 / 14.9 MB |
| 想起、k=3、プール 8(採用設定):ヒット率 | 91% / 93% | 93% / 95% | 100% / 97% |
| 同条件、短いエージェント風クエリ | 94% | 95% | 98% |
| 想起、k=8、プール 8:ヒット率 | 100% | 100% | 100% |
| リランク付き想起、k=3、プール 32:ヒット率 | 99% | 99% | 100% |
| 想起レイテンシ p50 / p95(リランクなし) | 0.15–0.20 / 0.22 s | 0.16–0.19 / 0.23 s | 0.18–0.19 / 0.24 s |
| 想起レイテンシ p50(リランクあり) | 3.1 s | 3.0 s | 3.1 s |
| 想起 1 回あたりのピークメモリ | 231 MB(リランク時 1.64 GB) | 234 MB(1.65 GB) | 240 MB(1.66 GB) |
| 会話を 1 件追加(増分インデックス化) | 1.2–1.8 s, 270 MB | 8–9 s, 305 MB | 4.5–4.8 s, 390–400 MB |
| ゼロからインデックス化(バックフィル) | 68–70 s, 650 MB | 242 s, 1.26 GB | 19.5 分, 1.9 GB |
| ディスク上の記憶ディレクトリのサイズ | 86 MB | 605 MB | 424 MB |
各サイズ 100 問、4 CPU。セルに値が 2 つある場合は、毎回フルの再インデックス化を伴うベンチマークを 2 回実行したものです。ばらつきは、インデックス構築の実行間変動です。
測定結果からわかること:
- 想起のレイテンシは、履歴の量に左右されない。 想起 1 回あたり約 0.2 秒・240 MB で、これは会話数が 1,000 件でも 10,000 件でも変わりません。その大半は、プロセスの起動と埋め込みモデルの読み込みです。規模感としては、1 日に 10 回チャットするエンジニアなら、年間で約 2,500 会話が積み上がります。
- 質問が失われることはなく、カットラインの下に沈むだけ。 3 件ではなく 8 件の一節を返すようにすると、どのサイズでも全問がヒットしました。3 件のままだと、最大 9% の質問を取りこぼしました。調べてみると、取りこぼしには共通の原因が 1 つありました。別の設備についてのほぼ同一の事実(K-039、K-019、K-007 の「振動アラームが何度も出る」)が、正解より上位に来てしまうのです。長く言い換えられた質問が、意味の上ではそれらとも一致してしまい、区別できる要素が ID だけだったからです。同じ質問を「コンプレッサー K-047 チケット」と短く詰めると、正しい会話が 1 位に来ました。エージェントがツール呼び出しを書くときの言い回しも、もともとこれに近いものです(私たちのエージェントのクエリは
MT-4471 K-2 compressor closedのような形でした)。そして短いクエリは、全体として少し高いスコアになりました。ツールの説明文には「識別子を中心にした短いクエリを使う」という一文を加えました。 - リランカーは k=3 の取りこぼしを買い戻せるが、代償は大きい。 k=3 でも 99〜100% に達しますが、レイテンシは 15 倍、メモリは 7 倍、イメージには 1.1 GB のモデルが必要になります。一節を多く返す方法なら、レイテンシのコストなしに同じ精度が得られ、代わりにコンテキストのトークンを使います。私たちが k=3 のままにしているのは、最初の試みで質問に答えられなければエージェントが聞き直すからです。あなたのエージェントがそうしないなら、k(と文字数の上限)を上げてください。
- インデックス化は、効いてほしいところで安く済む。 新しい会話は、リクエストの経路から外れたところで、数秒・数百 MB のうちに検索可能になります。10,000 会話分の履歴をゼロから構築するのには 20 分・2 GB かかります。これは一度きりのバックフィルなので、サーバーの中でやるのではなく、バッチジョブとして実行してください。
- ディスク使用量は控えめだが、線形ではない。 記憶ディレクトリには、ベクトル、全文検索インデックス、テーブルのバージョンが入っています。そのサイズはストレージエンジンがどれだけコンパクションを行ったかに左右されます。今回の実行で 3,000 会話の方が 10,000 会話より容量を使ったのは、これが理由です。非常にヘビーなユーザーなら数百 MB、典型的なユーザーなら数 MB を見込んでおいてください。
これは何で、何でないか
| そうであるもの | そうでないもの |
|---|---|
| ユーザー自身の過去のチャットを、そのままの形で検索する | ナレッジベースや、ユーザーのプロファイル |
| エージェント起点:いつ振り返るかはエージェントが決める | 毎回のプロンプトに黙って注入されるコンテキスト |
| エージェントが引用でき、ユーザーが検証できる、日付付きの一節 | 出典のない、抽出された「事実」 |
| ユーザーごとに、呼び出し元のトークンで分離されている | チームで共有する知識(それは別の、意図的な設計が必要になる) |
| 追記のみの履歴 | チャットでそう言われていない限り、チケットがクローズされたことを知っているもの、ではない |
限界
- 履歴は真実ではない。 想起が返すのは言われたことであり、そこには間違いや、実現しなかった計画も含まれます。私たちのエージェントはこれをうまく扱えました(「メモには解決したかどうか書かれていません」)が、それはエージェントとそのプロンプトによるものです。ツール自体はそれを保証できません。
- 想起したチャット自体も記憶される。 想起を使った会話の回答も、他のターンと同じようにインデックス化されます。たいていはこれが助けになります。まとめられた To Do リストも検索できるようになるからです。しかし、間違った想起の回答もまた、将来の「記憶」になってしまいます。ほぼ想起の出力だけでできているターンを除外するのは、妥当な改良点です。
- 削除は再構築を意味する。 funes は追記のみです。「この会話を忘れて」は、元のファイルを削除し、そのユーザーのディレクトリを再インデックス化することを意味します。1 人のユーザーについてなら安く済みますが、それでも、プライバシーの要求や保持ポリシーのために必要な、明示的な操作であることに変わりはありません。
- 秘密情報や個人データも残り続ける。 ユーザーがチャットに貼り付けたものは何でも、その人の記憶に入ります。転送する前にゲートウェイでマスキングし、保持期間はあらかじめ決めておいてください。(funes には秘密情報向けの
scrubコマンドがありますが、業務データ向けではありません。) - 埋め込みは英語優先。 bge-small-en は英語のモデルです。BM25 なら、どの言語であっても正確なコードには一致しますが、他の言語での意味ベースの検索には、多言語対応の埋め込みモデルが必要です。
- エージェントの振る舞いは一定しない。 リクエストにツール名が明示されていない限り、振り返るかどうかはエージェントが判断しなければなりません。よくできたツールの説明文で、たいていはそこまで持っていけます。残りは、システムプロンプトの一文(「ユーザーが以前の作業に言及したら、答える前に想起すること」)が埋めてくれます。
- 呼び出しごとに 1 プロセス。 シンプルで頑丈ですが、どの想起呼び出しも、プロセスの起動とモデルの読み込みのコスト(約 0.2 秒のうちの一部)を払うことになります。リクエスト頻度が非常に高い場合は、テナントごとに長時間稼働する funes の MCP サーバー(
funes mcp <memory>)を使えば、これを避けられます。
まとめ
エージェントが毎回ゼロから始めるのをやめるのに、脳移植は要りません。必要なのは、すでに起きたことの中から調べる手段です。検索を funes に任せれば、この機能全体は、完了したターンを保存する 1 つのルートと、呼び出し元の身元のもとでそれを検索する 1 つのツール、そしてバージョンを固定したバイナリとモデルを焼き込んだ 1 つのコンテナに収まります。これは SF 的な意味での記憶ではありません。想起です。日付が付いていて検証可能な、過去へのヒントを、エージェントが必要なときに求める。それだけのことです。エージェントを使う人にとっては、「N-11 が何だったか思い出させて」と言うのと、「MT-4471 がクローズしたらアップグレードを進めると決めましたね。まだ未解決です」と言われるのとでは、大きな違いがあります。
完全なデモ(サーバー、Dockerfile、compose ファイル、シード用の会話、エージェントのラッパー、ベンチマーク)は、付属のリポジトリにあります。