ある月曜日、私たちが使っていたクラウド検索サービスが停止しました。復旧の見込みもありません。エージェントのツールのうち 2 つがこれに乗っていました。1 つは質問に合うデータベースのテーブルを見つけるもの、もう 1 つは製品ドキュメントを検索するものです。これらがなくてもエージェントは答えましたが、その答えは記憶から来たものであり、それこそドキュメント検索ツールが防ぐはずのものでした。
選択肢は 2 つでした。待つか、ローカルな代替を作るか。私たちは 1 日で作りました。エージェントのツールサーバーの隣で小さなコンテナとして動き、クラウドのアカウントも不要で、起動は約 1 秒です。1 日後、クラウドのインデックスが復旧し、ようやく後回しにしていたことができました。同じ質問を両方に投げて、どれくらい差があるかを見る、というものです。
この記事は、MCP 上でのエージェント向けツール群についてのシリーズを続けます。1 本目は、エージェントに Python のためのサンドボックスを用意しました。2 本目は、行ではなく参照を渡しました。3 本目は、テーブル検索に小さな決定モデルを試しました。そして 4 本目は、エージェントに過去のチャットを検索できる想起機能を与えました。その記事では funes を使い、funes はインデックスを Lance 形式で保存します。ここで Lance が再登場します。
「ローカル RAG」が代わりに担うもの
マネージドの検索サービスは、次の 4 つを代わりにやってくれます。
- キーワード検索(BM25)、ステミングとフィールドブースト付き。
- ベクトル検索。インデックス時とクエリ時に、埋め込みモデルを代わりに呼び出してくれます。
- 2 つのリストの融合(ハイブリッド検索)、そして任意で、その上にリランカー。
- 運用:ストレージ、スケーリング、API、キー。
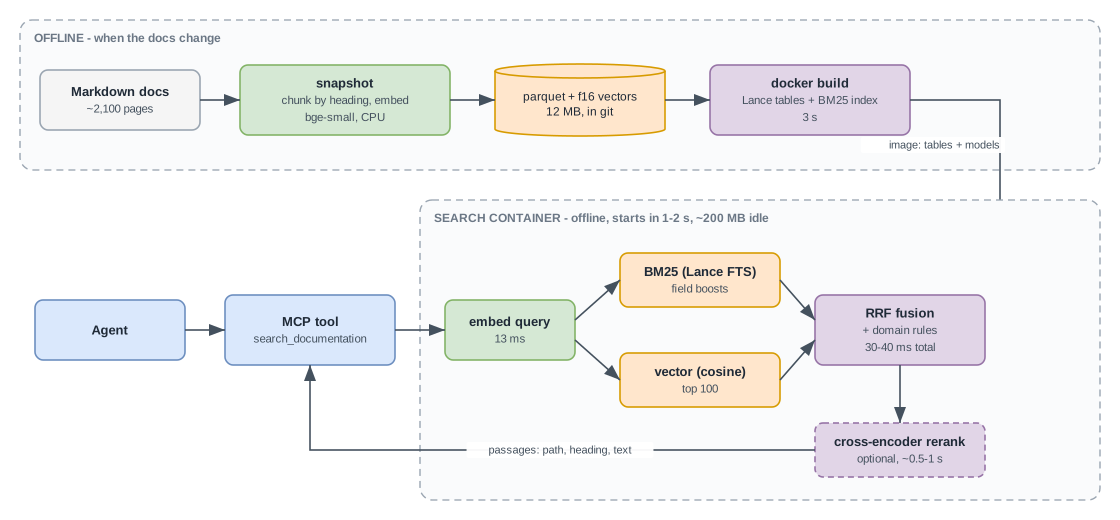
最初の 3 つは、1 つの Python プロセスに収まります。4 つ目は、コーパスが分単位ではなくリリースごとに変わる、数千件規模のドキュメントであれば、たいてい必要なくなります。私たちのドキュメントは約 2,100 ページの Markdown(画面ヘルプ、技術メモ、手順、リリースノート)で、これが 9,000 個のパッセージになります。小さな規模です。ノート PC の CPU で十分です。
スタック
| 役割 | 選択 | 理由 |
|---|---|---|
| ストレージ、BM25、ベクトル検索 | LanceDB 0.41 | 1 つの組み込みライブラリが両方の検索をこなし、ファイルはディスク上、サーバーなし |
| 埋め込み | BAAI/bge-small-en-v1.5(fastembed 経由) | 384 次元、CPU 上で ONNX、3,300 万パラメータ |
| リランカー(任意) | jinaai/jina-reranker-v1-turbo-en(fastembed 経由) | 小さなクロスエンコーダー、これも CPU |
| エージェント側のインターフェース | MCP ツール(FastMCP)か、ただの HTTP ルート | エージェントがすでに呼んでいるものに合わせる |
GPU もモデル API もベクトルデータベースサーバーも要りません。モデルはイメージをビルドするときに一度だけダウンロードされ、コンテナはオフラインで動きます。
ステップ 1:チャンクに分けてインデックス化する
各ページを ##/### の見出しで切り分け、見出しのパスをパッセージと一緒に保持します。見出しに揃えたチャンクが固定長ウィンドウより優れているのは、ヘルプページのセクションがたいてい 1 つの質問にそれぞれ答えており、見出しが著者の与えてくれる最良の要約だからです。
def chunks(root, max_chars=1600):
    for path in sorted(Path(root).rglob("*.md")):
        text = path.read_text(errors="ignore")
        title = next(iter(re.findall(r"^# (.+)$", text, re.M)), path.stem)
        for section in re.split(r"\n(?=#{2,3} )", text):
            heading = section.splitlines()[0].lstrip("# ").strip() if section.startswith("#") else ""
            for i in range(0, len(section), max_chars):
                yield {"path": str(path.relative_to(root)), "title": title, "heading": heading, "text": section[i:i + max_chars]}


def build(root, data_dir):
    rows = list(chunks(root))
    embedder = TextEmbedding("BAAI/bge-small-en-v1.5")
    vectors = embedder.embed([f"{r['title']} > {r['heading']}\n{r['text']}" for r in rows], batch_size=64)
    for r, v in zip(rows, vectors):
        r["vector"] = v.tolist()
    table = lancedb.connect(data_dir).create_table("docs", data=rows, mode="overwrite")
    table.create_fts_index("text", use_tantivy=False, language="English", stem=True, remove_stop_words=True)
タイトルと見出しをテキストと一緒に埋め込みます。「レコードを追加するには Insert を押してください」というパッセージは、その上にある「設備のダウンタイム > イベントの入力」がなければ意味を持ちません。
ステップ 2:reciprocal rank fusion によるハイブリッド検索
両方の検索を実行し、スコアではなくランクで統合します。BM25 のスコアとコサイン距離は異なるスケールに属しており、reciprocal rank fusion(RRF)を使えば、それらを揃える必要がなくなります。各リストは文書に 1 / (60 + rank) を与え、その合計で決まります。
def search(self, query, k=5):
    vec = next(iter(self.embedder.embed([QUERY_PREFIX + query])))
    keyword = self.table.search(query, query_type="fts").with_row_id(True).limit(50).to_list()
    semantic = self.table.search(vec).distance_type("cosine").with_row_id(True).limit(50).to_list()
    scores, rows = {}, {}
    for hits in (keyword, semantic):
        for rank, r in enumerate(hits):
            scores[r["_rowid"]] = scores.get(r["_rowid"], 0) + 1 / (60 + rank + 1)
            rows[r["_rowid"]] = r
    top = [rows[i] for i in sorted(scores, key=scores.get, reverse=True)[:max(k, 10)]]
    if self.reranker:
        ce = list(self.reranker.rerank(query, [f"{r['title']} > {r['heading']}\n{r['text'][:1000]}" for r in top]))
        top = [r for _, r in sorted(zip(ce, top), key=lambda p: -p[0])]
    return top[:k]
QUERY_PREFIX は、bge モデルがクエリ側で学習時に使った指示文です(「Represent this sentence for searching relevant passages: 」)。パッセージはこれなしで埋め込まれます。
ステップ 3:ツールとして公開する
mcp = FastMCP("local-docs")

@mcp.tool
def search_documentation(query: str, k: int = 5) -> list[dict]:
    """Search the product documentation. Returns passages with file path and heading; cite the path."""
    return search(query, min(k, 10))

mcp.run(transport="http", host="0.0.0.0", port=8080)
これが汎用版のすべてです。約 90 行で、300 ページのサンプル(686 パッセージをノート PC で 70 秒でインデックス化、リランカーを有効にした状態でツール呼び出し 1 回あたり 0.5〜0.7 秒)でテストしました。
ステップ 4:あなた自身に固有の部分
汎用パイプラインで、道のりの大部分は片付きます。残りは、ライブラリからではなく評価セットから来ました。私たちのプロダクション版で数値を変えたのは、次のようなものです。
- 構造化されたフィールドには、それぞれ専用のブーストを与える。 BM25 は複数のフィールドにわたって動きます:
title×3、ページ名とコード ×3、headings×2、text×1。 - クエリ中のコードは、正確な信号になる。 質問がページコード(
MT.0020)を名指しすると、そのページ自身のヘルプページが最上位に固定されます。埋め込みはコードをぼかしますが、フィルターはぼかしません。 - マニュアルはリリースノートに勝る、 質問がバージョンやリリースについて尋ねている場合を除いて。リリースノートはすべてに言及し、何も説明しません。
- 1 ページにつき最大 2 パッセージまで、 1 つの長いページが結果リスト全体を埋めてしまわないように。
- 事前確率としての人気度(テーブル検索ツール向け):他の多くのテーブル説明から言及されているテーブルは、名前が似ている無名のビューよりも答えである可能性が高い。この 1 つの事前確率が、そこで最大の効果をもたらしました。
これらはそれぞれ 1〜2 行のスコアリングコードで、固定の質問セット(hit@k、MRR)に対して調整し、変更するたびに再実行しました。このセットがなければ、感覚だけで調整することになっていたでしょう。
ステップ 5:起動をつまらないものにする
9,000 個のパッセージを埋め込むには、ノート PC の CPU で約 22 分かかります。だからこそ、コンテナは起動時にこれを絶対にやってはいけません。パイプラインを 3 段階に分けました。
| ステージ | いつ | コスト |
|---|---|---|
snapshot:コーパス → 行と float16 ベクトルを持つ parquet | ドキュメントが変わったとき;結果はコミットする | ノート PC でフル実行約 25 分、コア数の多いマシンなら数分;変化のないパッセージはベクトルを再利用(モデル名とテキストのハッシュをキーにする) |
build:parquet → Lance のテーブルと全文検索インデックス | docker build | 3 秒 |
serve:テーブルを開き、モデルを読み込む | コンテナ起動時 | 1〜2 秒 |
両方のコーパス(ドキュメントとテーブル説明)を合わせても、parquet のスナップショットは 12 MB です。モデルはイメージに焼き込まれ、コンテナは HF_HUB_OFFLINE=1 で動き、ネットワークを無効にした状態で 4 秒で準備が整います。アイドル時のメモリは約 200 MB です。
これまでできなかった比較
クラウドのインデックスが復旧したとき、私たちはエージェント評価スイートから取った 15 件のドキュメント質問で、両方のシステムを走らせました。各質問には、正解が引用すべきページ、つまり正解のページコードの集合があります。n 番目のパッセージがそれらのページのいずれかに属しているか、それを名指ししていれば、ランク n でのヒットとして数えます。両方のインデックスは、同じ Markdown のナレッジベースから構築されています。
クラウド側では、同じインデックスに対して 3 つのモードを試しました。キーワードのみ、ハイブリッド(キーワードに text-embedding-3-small のベクトル、1,536 次元を加えたもの)、そしてサービスのセマンティックリランカーを加えたハイブリッドです。各質問は 2 回尋ねました。エージェントが書くような短い検索クエリとして、そして生のユーザー質問としてです。
エージェント風のクエリ(例:「equipment downtime registration screen」):
| システム | hit@1 | hit@5 | MRR | p50 レイテンシ |
|---|---|---|---|---|
| ローカル:ハイブリッド + リランク | 0.60 | 0.87 | 0.71 | 0.99 s |
| ローカル:ハイブリッド、リランクなし | 0.60 | 0.80 | 0.70 | 0.03 s |
| クラウド:キーワード | 0.40 | 0.80 | 0.57 | 0.87 s |
| クラウド:ハイブリッド | 0.67 | 1.00 | 0.81 | 1.10 s |
| クラウド:ハイブリッド + セマンティックリランク | 0.53 | 0.80 | 0.67 | 1.18 s |
生のユーザー質問(例:「How is equipment downtime registered? Is it the same as a planned outage, and where do I record it?」):
| システム | hit@1 | hit@5 | MRR | p50 レイテンシ |
|---|---|---|---|---|
| ローカル:ハイブリッド + リランク | 0.47 | 0.87 | 0.64 | 1.11 s |
| ローカル:ハイブリッド、リランクなし | 0.47 | 0.80 | 0.57 | 0.04 s |
| クラウド:キーワード | 0.27 | 0.67 | 0.47 | 0.92 s |
| クラウド:ハイブリッド | 0.47 | 0.93 | 0.63 | 1.17 s |
| クラウド:ハイブリッド + セマンティックリランク | 0.53 | 0.73 | 0.61 | 1.31 s |
この結果の読み方:
- クラウドのハイブリッドは、きれいなクエリでは最良のシステムです。 15 件すべてで、トップ 5 以内に正解ページを見つけました。より大きな埋め込みモデルの効果がここに表れています。特に、語の重なりが少ない短いクエリで。
- 生の質問では、両者はほぼ同じレベルです(MRR 0.64 対 0.63)。長く、口語的な質問にはリランカーが必要です。リランカーなしでは、ローカルの MRR は 0.57 まで落ちます。
- キーワードのみの検索は、両側で明らかに劣ります。 あなたの「ローカル RAG」が BM25 だけなら、MRR で 15〜25 ポイントを捨てていることになります。
- クラウドのセマンティックリランカーは、このセットでは役に立ちませんでした。 一部の正解ページを 1 位に押し上げましたが、別のものをトップ 5 の外に押し出しました。お金を払う前に測ってください。
- 15 件は小さなサンプルです。 1 件の質問が hit@k を 0.067 動かします。0.1 未満の差はノイズとして扱ってください。69 件のドキュメント質問からなる完全なセットでは、ローカルエンジンは hit@5 が 0.83、MRR が 0.64 で、上の数値と一致しています。
テーブル検索:ドメインルールが効いてくるところ
2 つ目のツールは、質問を約 3,300 件のテーブル説明のいずれかに対応づけます。クラウドのインデックスにも同じ説明があります(3,298 件のドキュメント、text-embedding-3-small のベクトル、セマンティック設定)。手順は同じです。セットから 15 件の質問、正解は正しい答えが使うテーブルです。
| システム | エージェントクエリ:hit@1 | hit@5 | MRR | 生の質問:hit@1 | hit@5 | MRR |
|---|---|---|---|---|---|---|
| ローカル:ハイブリッド + 事前確率 + リランク | 0.53 | 0.87 | 0.67 | 0.67 | 0.80 | 0.72 |
| クラウド:キーワード | 0.27 | 0.33 | 0.33 | 0.13 | 0.40 | 0.26 |
| クラウド:ハイブリッド | 0.27 | 0.53 | 0.40 | 0.27 | 0.73 | 0.49 |
| クラウド:ハイブリッド + セマンティックリランク | 0.47 | 0.87 | 0.62 | 0.33 | 0.73 | 0.49 |
ここでは構図が逆転します。テーブル名は密な略語で、多くのテーブルがほとんどの単語を共有しています(「拠点別の日次合計」「拠点別の月次合計」、同じものの読み取り専用の日次サマリー)。汎用的な関連性判定ではこれらを区別できませんが、人気度の事前確率、時間粒度の手がかり(「日次」「月次」)、そして名前に含まれる略語の展開であれば区別できます。クラウドのセマンティックリランカーは、このインデックスではコストに見合う働きをします(エージェントクエリで MRR 0.40 → 0.62)が、生の質問では依然として大きく後れを取ります。
両方のツールについて、1 つ正直に言っておくべきこと: ローカルの重みは、この 15 件の質問が取られたのと同じスイートでチューニングされています。これはクラウドのインデックスにはない、サンプル内での優位性です。これが最も影響するのは、ルールが最も具体的なテーブル検索です。テーブル検索での差は、「ローカルエンジンの方が全般的に優れている」ではなく、「ドメインルールには大きな価値がある」と読んでください。
どれくらい速いのか?
| ステップ | 中央値 |
|---|---|
| クエリの埋め込み(bge-small) | 13 ms |
| BM25 + ベクトル検索、それぞれ上位 100 件 | 30–40 ms |
| クロスエンコーダーのリランク、20 パッセージ | ~1,000 ms |
| クロスエンコーダーのリランク、10 パッセージ | ~500 ms |
検索そのものは実質無料で、時間がかかるのはリランカーの部分です。20 件ではなく 10 件のパッセージをリランクすることで、エージェント風クエリでは変化なし(MRR はどちらも 0.71)でコストが半分になり、生の質問ではわずかな低下があります(0.64 → 0.61)。あなたのエージェントが良い検索クエリを書くなら(ツールの説明文でそう求めることができます)、リランカーを切って約 40 ms で答えられます。
クラウドの数値には、ヨーロッパのノート PC からアメリカのリージョンまでの往復と、ハイブリッドモードではサービス自身による埋め込みモデルの呼び出しが含まれています。同じリージョンであれば、もっと低くなるはずです。ローカルの数値には、ネットワークのホップが一切ありません。
長所と短所
| ローカル | クラウド検索サービス |
|---|---|
| アカウントもキーも不要、送信データもなし:ドキュメントが外に出ない | マネージド:スケーリング、可用性、セキュリティレビューを他の誰かがやってくれる |
| インデックスはファイル:コードと一緒にバージョン管理でき、再現可能、diff もできる | インデックスはサービスの中にある:再構築はコミットではなくパイプライン |
| すべてのランキングルールを自分で変更・テストできる(テーブル検索:生の質問で MRR 0.72 対 0.49) | ランキングの調整ノブは、サービスが公開している範囲に限られる |
| リランクなしで 30–40 ms | 標準でより大きな埋め込みモデルが使える |
| エアギャップ環境や顧客ホスティングでも動く | 数百万件のドキュメントと頻繁な更新を扱える |
| チューニング、モデル更新、評価セットを自分で持つ | 短く一般的なクエリでの初回品質が良い(ドキュメント:MRR 0.81 対 0.71) |
| モデルとランタイムを含め ~2 GB のイメージ、CPU 負荷の高いリランカー | 検索ユニットごとの固定月額料金、加えて埋め込み呼び出しの費用 |
自分でやってみるとどうなるか
- 1 日目: 上の汎用パイプライン、コンテナ 1 つ、そしてエージェントのツールをそちらに切り替えること。エージェントは再び本物のページを引用するようになります。
- 2 日目: 既知の答えを持つ 50〜100 件の実際の質問からなる評価セットと、ステップ 4 のドメインルール。ここで、クラウドのハイブリッドモードに近づきます。
- 継続的に: ドキュメントが変わったら
snapshotを再実行し、重みをいじるたびに評価を再実行してください。埋め込みモデルを変えるということは、すべてを再埋め込みするということなので、1 つを選んだら使い続けてください。 - 向いていないもの: 分単位で変わるコーパス、数百万件のドキュメント、多言語(bge-small は英語モデルです。多言語モデルもありますが、まず評価してください)。
限界
- 埋め込みの次元数は、短いクエリで重要になります。 384 次元の CPU モデルは安価で優秀ですが、語の重なりが少ない短いクエリでは、1,536 次元の API モデルには及びません。ドメインルールとリランカーがその差の大部分を埋めますが、完全には消せません。
- クロスエンコーダーは CPU への税金です。 20 パッセージで約 1 秒。これを見込んでコンテナのサイズを決めるか、長い質問だけに限定してください。
- 評価セットこそが製品です。 この記事のすべての数値は、誰かが書いて採点しなければならなかった質問セットから来ています。それがなければ、何かの変更が役に立ったかどうかはわからず、何とも比較できません。
- サンプル内でチューニングされている。 私たちの重みは、比較に使ったのと同じ質問スイートから来ています。公正な再戦には、チューニング後に書かれたホールドアウトセットが必要です。
まとめ
クラウドの検索インデックスは便利ですが、置き換え不可能というわけではありません。数千件規模のドキュメントのコーパスであれば、BM25 とベクトルを使う組み込みエンジン、小さな CPU 埋め込みモデル、そして reciprocal rank fusion があれば、1 日で実際に使える代替が手に入ります。いくつかのドメインルールとリランカーを加えれば、ドキュメント質問ではクラウドのハイブリッドモードとほぼ誤差の範囲に収まり、きれいで短いクエリでは一歩後れを取りますが、ドメインルールが仕事をするテーブル検索では大きく先を行きます。その見返りとして、インデックスはリポジトリの中の 1 つのファイルになり、ランキングはテストできるコードになり、何もマシンの外には出ません。パイプラインは簡単な部分です。次に作るとしたら、まず質問セットを最初に作るでしょう。