에이전트와의 모든 대화는 제로에서 시작합니다. 월요일에 누군가가 어시스턴트와 함께 두 현장의 실적을 검토하고, 어떤 후속 작업을 누가 맡을지 적어두고, 예산안을 확정합니다. 목요일에 새 대화를 열고 “N-11에 대해 뭘로 결정했었지?“라고 물으면, 에이전트는 N-11이 뭔지조차 모릅니다. 사용자는 화면을 거슬러 올라가고, 복사하고, 붙여넣고, 처음부터 다시 설명해야 합니다.
이 글은 아주 적은 코드로 그 간극을 어떻게 메웠는지 보여줍니다. 에이전트에게는 도구 하나, recall_my_conversations만 주어집니다. 이 도구는 현재 사용자 본인의 이전 대화를 검색해서 날짜가 붙은 구절을 반환합니다. 검색 엔진은 funes입니다. 직접 만드는 대신 재사용한 오픈소스 프로젝트입니다. 이를 이어붙이는 건 작은 FastMCP 서버이고, 모든 것이 컨테이너 하나 안에서 돌아갑니다.
이 글은 MCP 위에서의 에이전트 도구화를 다루는 연재의 세 번째입니다. 첫 번째 글은 에이전트에게 Python을 안전하게 실행할 공간을 마련해주었습니다. 두 번째 글은 행 대신 참조를 넘겨서 대량 데이터가 대화 기록 밖에 머물도록 했습니다. 이번 글에서는 에이전트가 대화 기록 자체를 뒤져볼 수 있게 합니다.
리콜은 기억이 아니다, 그리고 그래도 괜찮다
“에이전트의 기억"이라고 하면 보통 야심 찬 무언가를 떠올립니다. 대화에서 사실을 추출하고, 프로필을 최신으로 유지하고, 모순을 해소하고, 매 프롬프트마다 알맞은 맥락을 조용히 집어넣어주는 시스템 말입니다. 이건 만들기도 어렵고 믿기도 어렵습니다. 잘못되면 에이전트는 여러분이 말한 적도 없는 걸 “기억"해내고, 그게 어디서 나온 건지는 아무도 알 수 없습니다.
저희가 원한 건 훨씬 단순한 것, 자기 이메일을 직접 검색하는 사람에 더 가까운 방식이었습니다.
- 과거는 일어난 그대로 남습니다. 요약도, 다시 쓰기도, 병합도 하지 않습니다.
- 언제 되돌아볼지는 에이전트가 도구를 호출해서 직접 결정합니다.
- 돌아오는 건 날짜가 붙은, 그대로의 구절입니다. 에이전트는 이를 인용할 수 있고, 사용자는 이를 확인할 수 있습니다.
- 관련된 게 하나도 안 나오면, 에이전트는 그렇다고 말합니다.
리콜이 에이전트에게 주는 건 과거에 대한 단서입니다. 사용자에 대한 모델을 주는 게 아닙니다. 에이전트는 여전히 매번 처음부터 추론하지만, 더 이상 작업까지 처음부터 다시 하지는 않습니다. 지난주에 썼던 파라미터, 적어두었던 담당자, 내려졌던 결정을 사용자에게 다시 말해달라고 하는 대신 그대로 가져올 수 있습니다.
결과적으로 그것만으로 가치의 대부분을, 위험은 극히 일부만 지고 얻게 됩니다.
바퀴를 다시 발명하지 않는다: funes
과거 에이전트 세션을 검색하는 문제는 코딩 에이전트 세계에서는 이미 풀린 문제입니다. Hugging Face의 funes는 “과거 에이전트 세션에 대한 영구적이고 검색 가능한 기억"입니다. Claude Code, Codex 등의 대화 기록을 인덱싱해서 에이전트가 이전 작업을 리콜할 수 있게 해줍니다. (이 글을 준비하면서도 저희 자신의 예전 글을 찾는 데 썼습니다.)
개발자 노트북뿐 아니라 제품에도 잘 맞는 이유는 다음과 같습니다.
- 바이너리 하나, 서비스는 없음. 임베디드 스토리지 엔진(Lance)이 들어간 단일 Rust 실행 파일입니다. 돌려야 할 데이터베이스 서버도, 벡터 서비스도, 큐도 없습니다.
- 내부에 LLM이 없음. 검색은 두 개의 작은 로컬 모델, 즉 bge-small-en-v1.5 임베딩 모델과 선택적으로 쓰는 bge-reranker-base 크로스 인코더로 돌아갑니다. 아무것도 컨테이너 밖으로 나가지 않고, 리콜은 할루시네이션을 일으킬 수 없습니다. 실제로 존재하는 텍스트만 반환하기 때문입니다.
- 하나의 기억은 하나의 디렉터리.
FUNES_HOME=/some/dir이 독립된 기억을 만들어줍니다. 스토리지 레이어에 필요한 테넌트 분리는 사용자당 디렉터리 하나면 충분합니다. - 소박한 입력 형식. 인덱싱 대상은
.funes.jsonl파일입니다. 메시지 한 줄마다 세션 id, 일련번호, 타임스탬프, role, 텍스트 블록을 담습니다. 어떤 채팅 시스템이든 이 정도는 만들어낼 수 있습니다. - 에이전트를 위한 읽기 명령어:
recall(순위화된 검색),get(세션의 특정 범위 읽기),scan(한 세션 안의 정확한 문자열 검색),sessions,sketch. - 관대한 라이선스: funes는 Apache-2.0, 두 모델 모두 MIT입니다.
리콜이 내부에서 동작하는 방식
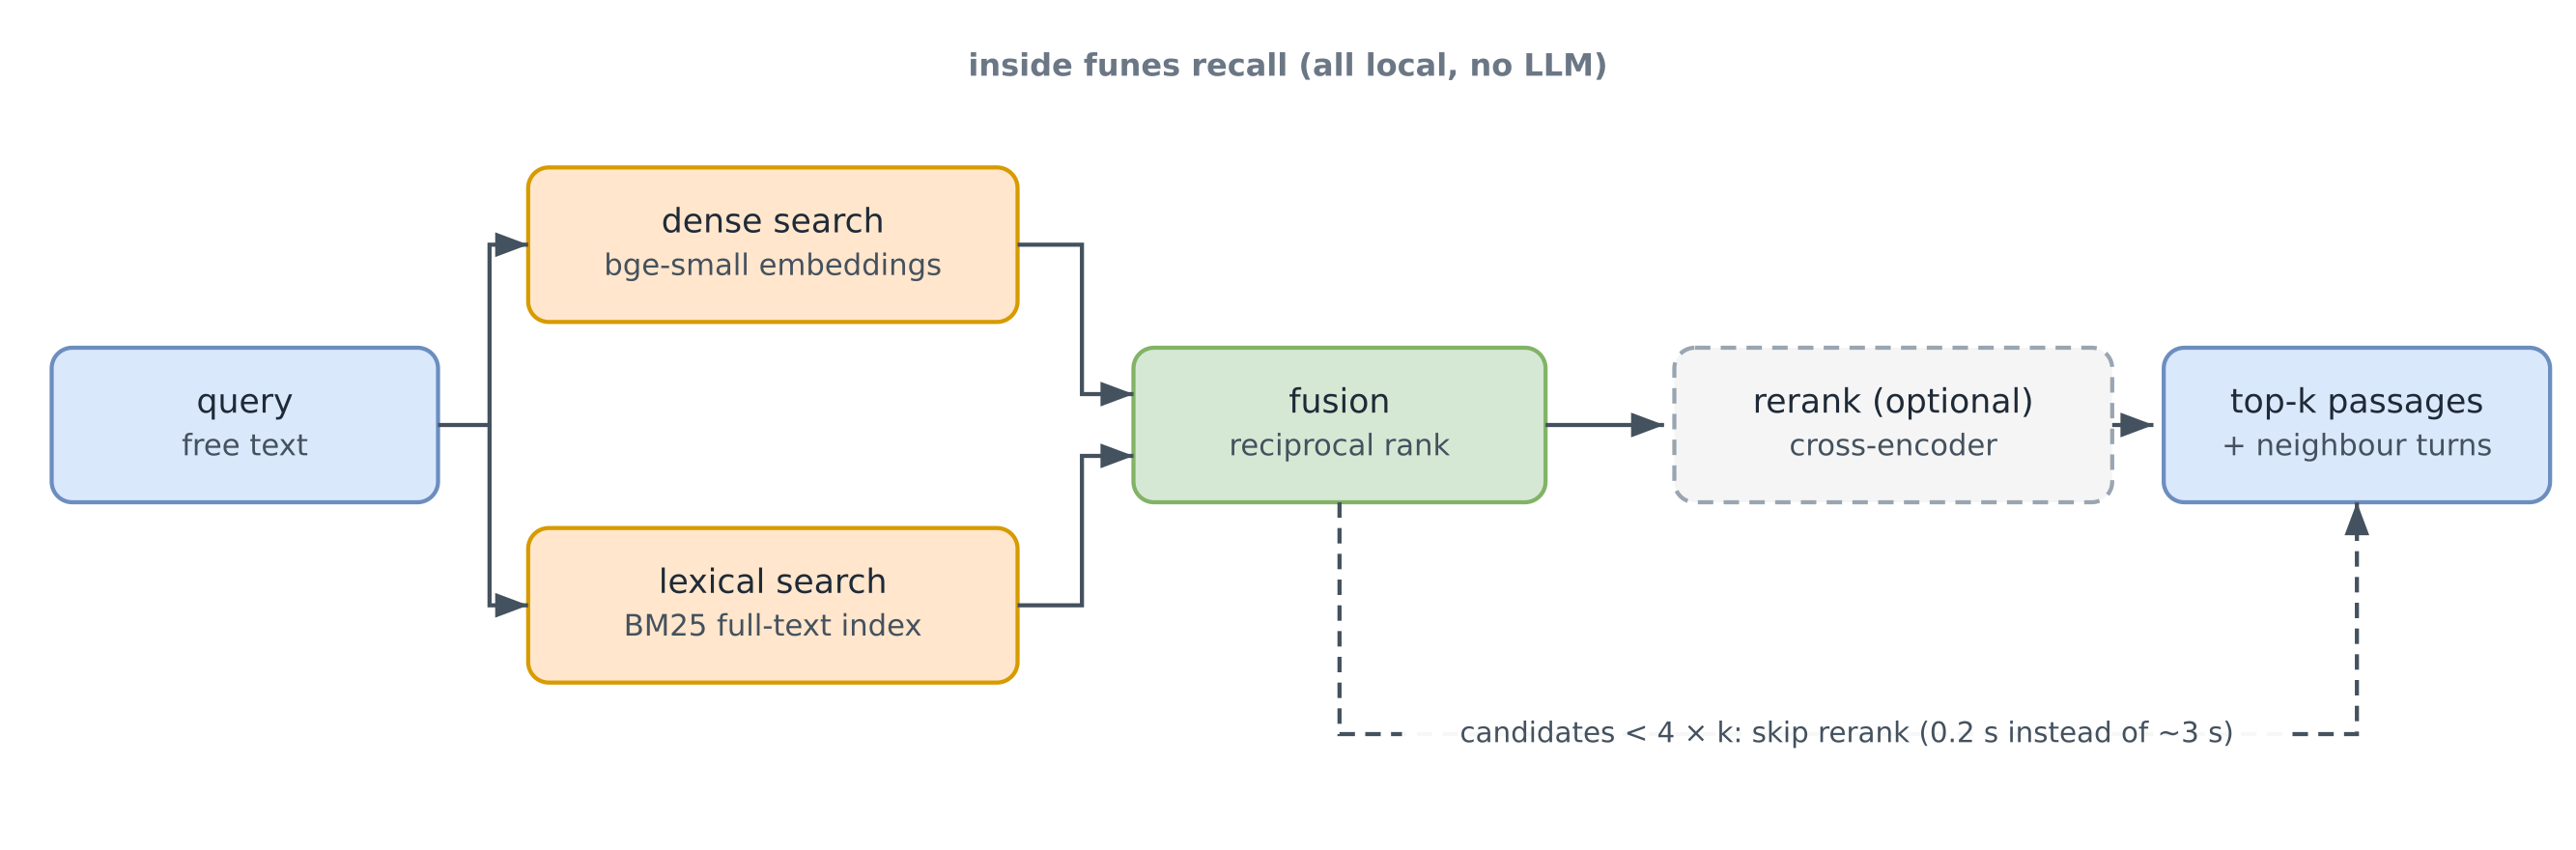
쿼리는 동시에 두 경로를 타고 내려갑니다. 밀집 벡터 검색은 비슷한 의미를 가진 구절을 찾습니다(“작업 지시서"로 “티켓"을 찾아내는 식입니다). BM25 전문 검색은 MT-4471이나 N-11처럼 임베딩이 잘 다루지 못하는 정확한 토큰을 찾아냅니다. 두 순위 목록은 reciprocal rank fusion으로 합쳐지고, 각 히트는 주변 턴과 함께 돌아오므로 에이전트는 답뿐 아니라 그 답으로 이어진 질문도 함께 보게 됩니다.
저희의 테이블 이름 검색 실험에서도 같은 분열을 봤습니다. 밀집 검색과 어휘 기반 검색은 서로 다른 쿼리에서 실패하고, 둘을 합치는 건 저렴한 보험입니다. funes는 이걸 기본으로 제공합니다.
선택적인 세 번째 단계는 후보 풀을 재채점하는 크로스 인코더입니다. funes는 후보 풀이 k의 4배 이상일 때 이를 켭니다. 호출당 약 3초와 1.6GB RAM이 듭니다(수치는 아래에). 대화형 리콜에서는 이를 꺼둡니다. 풀이 4 × k 아래로 유지되고, 첫 시도가 빗나가면 에이전트가 다른 단어로 다시 물어서 보완하기 때문입니다.
아키텍처
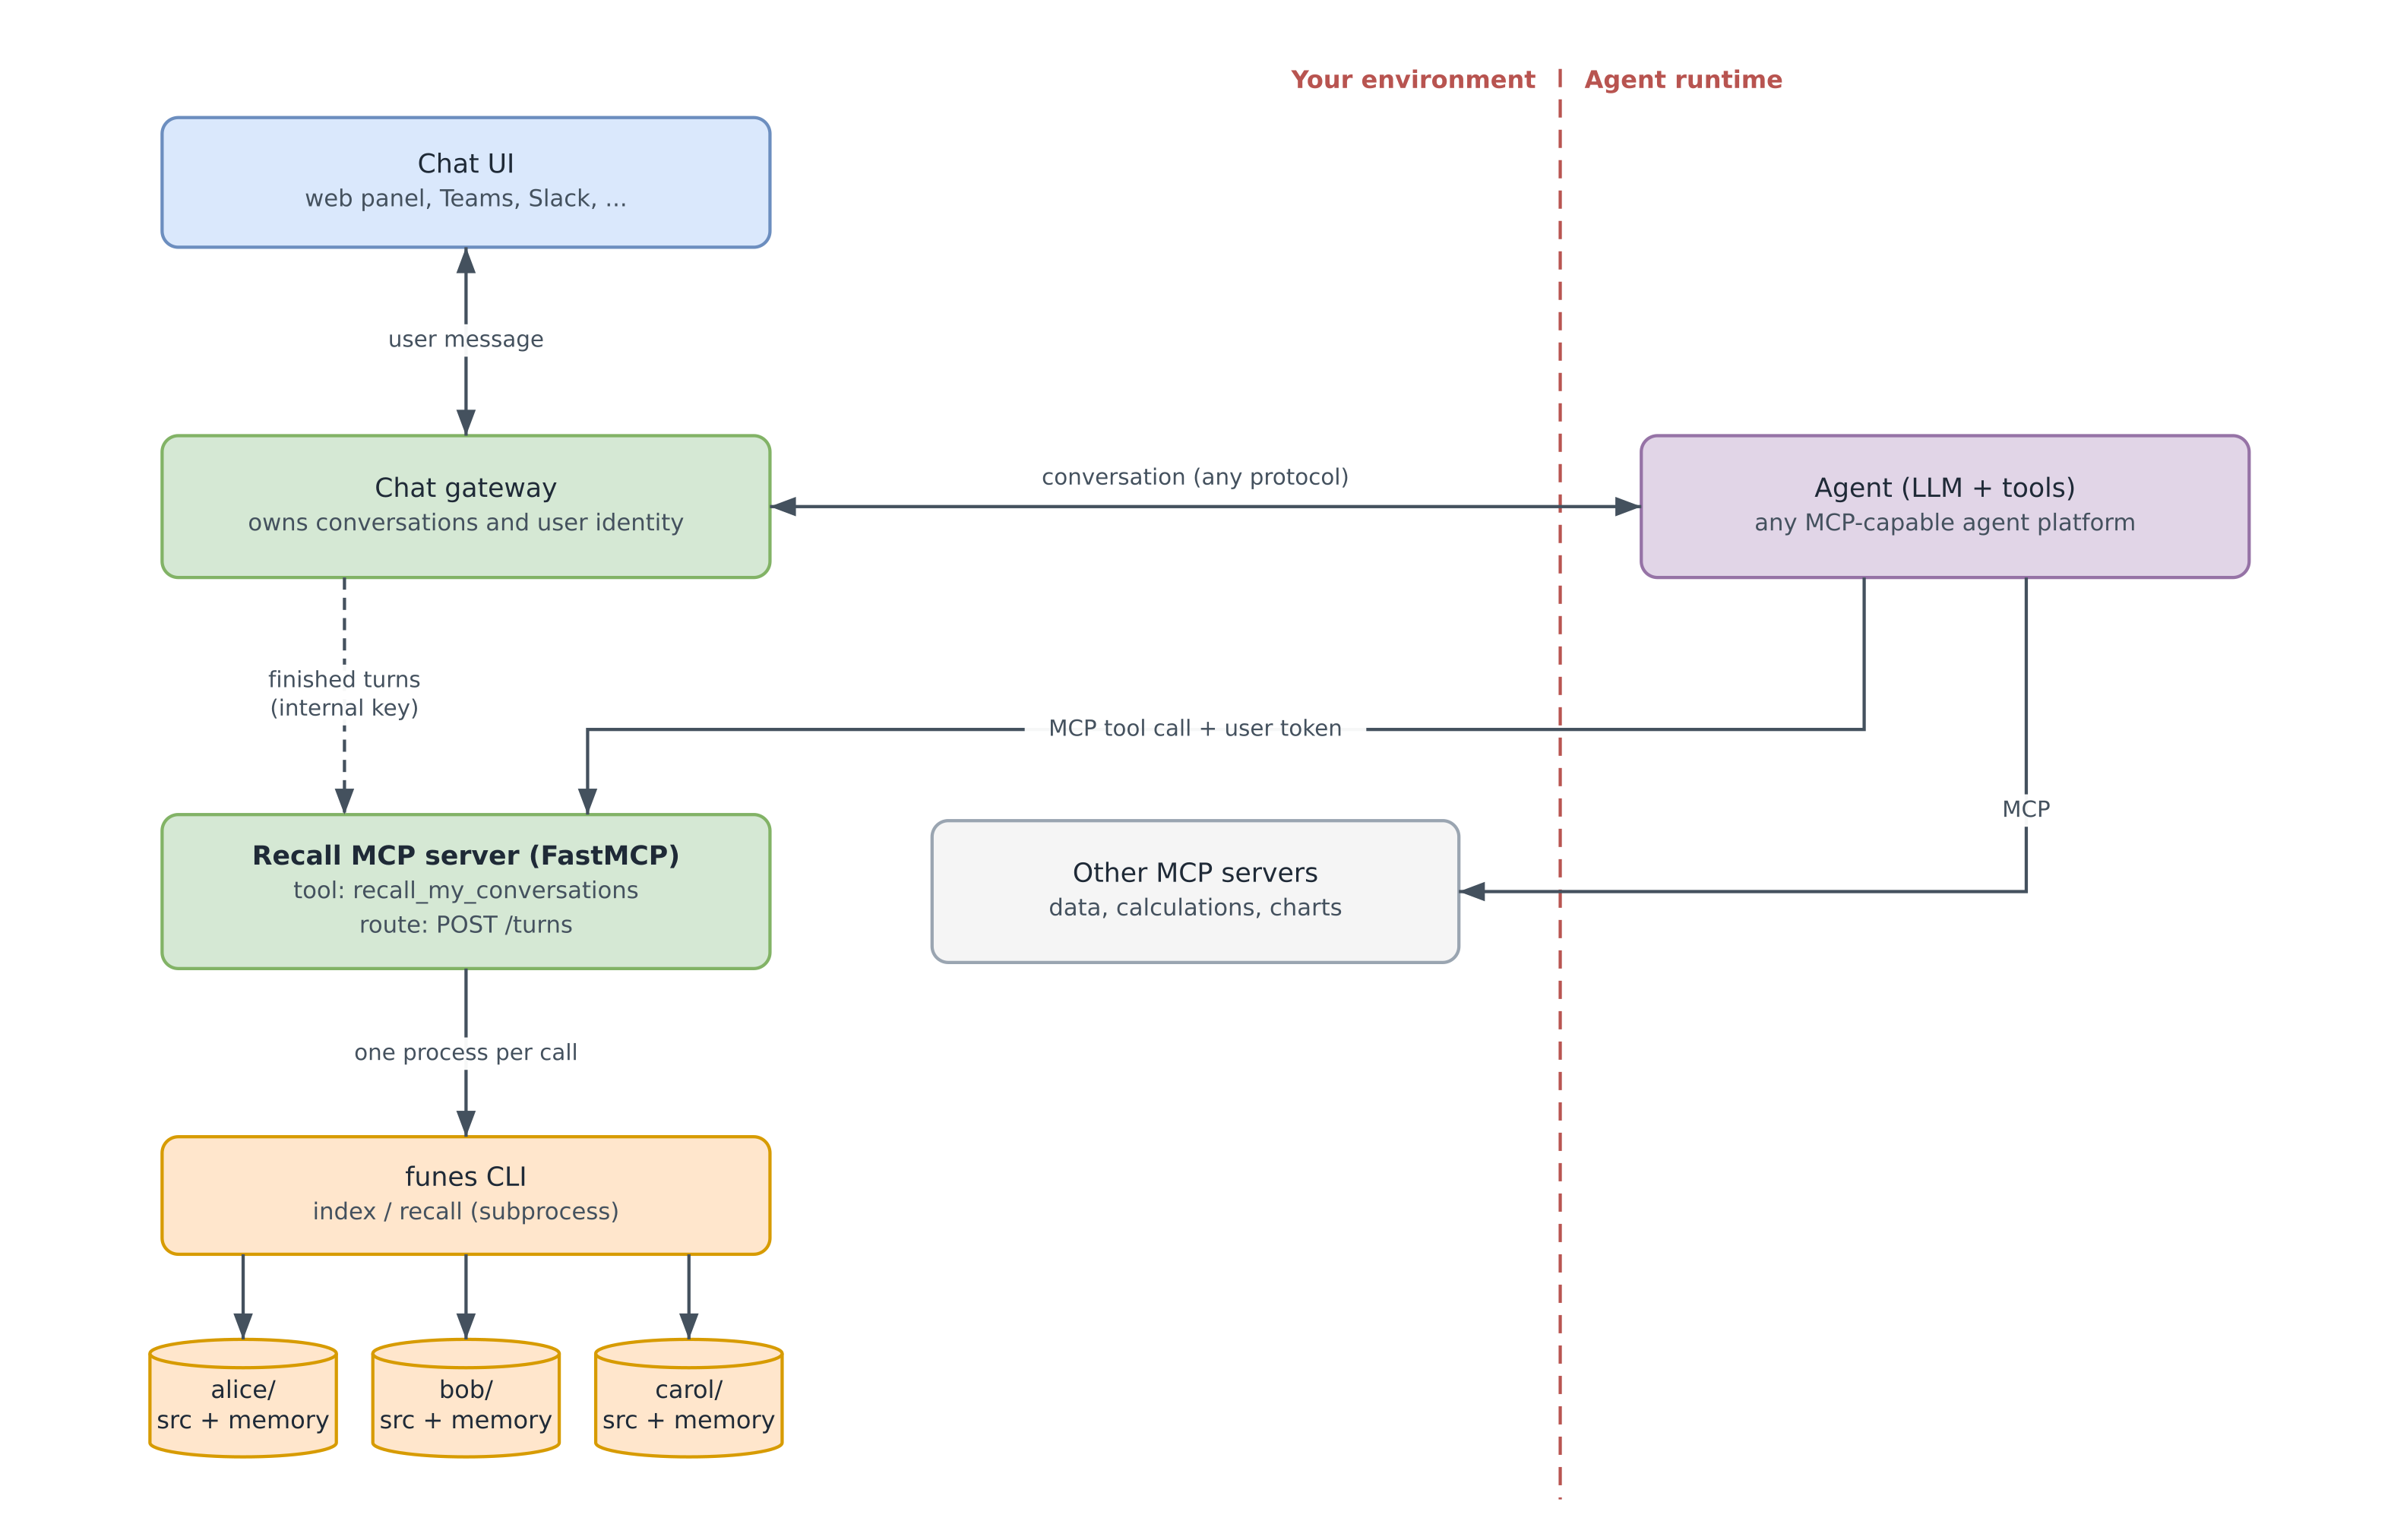
경로는 두 개이고, 의도적으로 서로 다른 자격 증명을 씁니다.
- 쓰기 경로(점선). 채팅 게이트웨이는 어차피 모든 메시지를 보고 있으므로, 완료된 각 턴을 공유 키로 보호된 내부 경로를 통해 리콜 서버로 전달합니다. 에이전트 플랫폼은 여기 관여하지 않습니다. 기억에 쓸 수도 없고, 프롬프트 인젝션이 “기억"을 심을 수도 없습니다.
- 읽기 경로. 에이전트는 다른 MCP 도구와 똑같이
recall_my_conversations를 호출합니다. 서버는 호출자의 토큰에서 사용자를 가져와 그 사용자의 디렉터리만 검색합니다. 누구의 기억을 검색할지를 쿼리 텍스트가 정하는 일은 절대 없습니다.
에이전트 플랫폼은 MCP를 말할 수 있는 것이라면 무엇이든 될 수 있습니다. 저희는 처음에 상용 에이전트 플랫폼 위에서 돌아가는 프로덕션 코파일럿 안에, Java MCP 서버로 이걸 만들었습니다. 아래 데모는 같은 설계를 Python만으로 자급자족하게 만든 버전입니다.
쓰기 경로: 완료된 턴을 전달하기
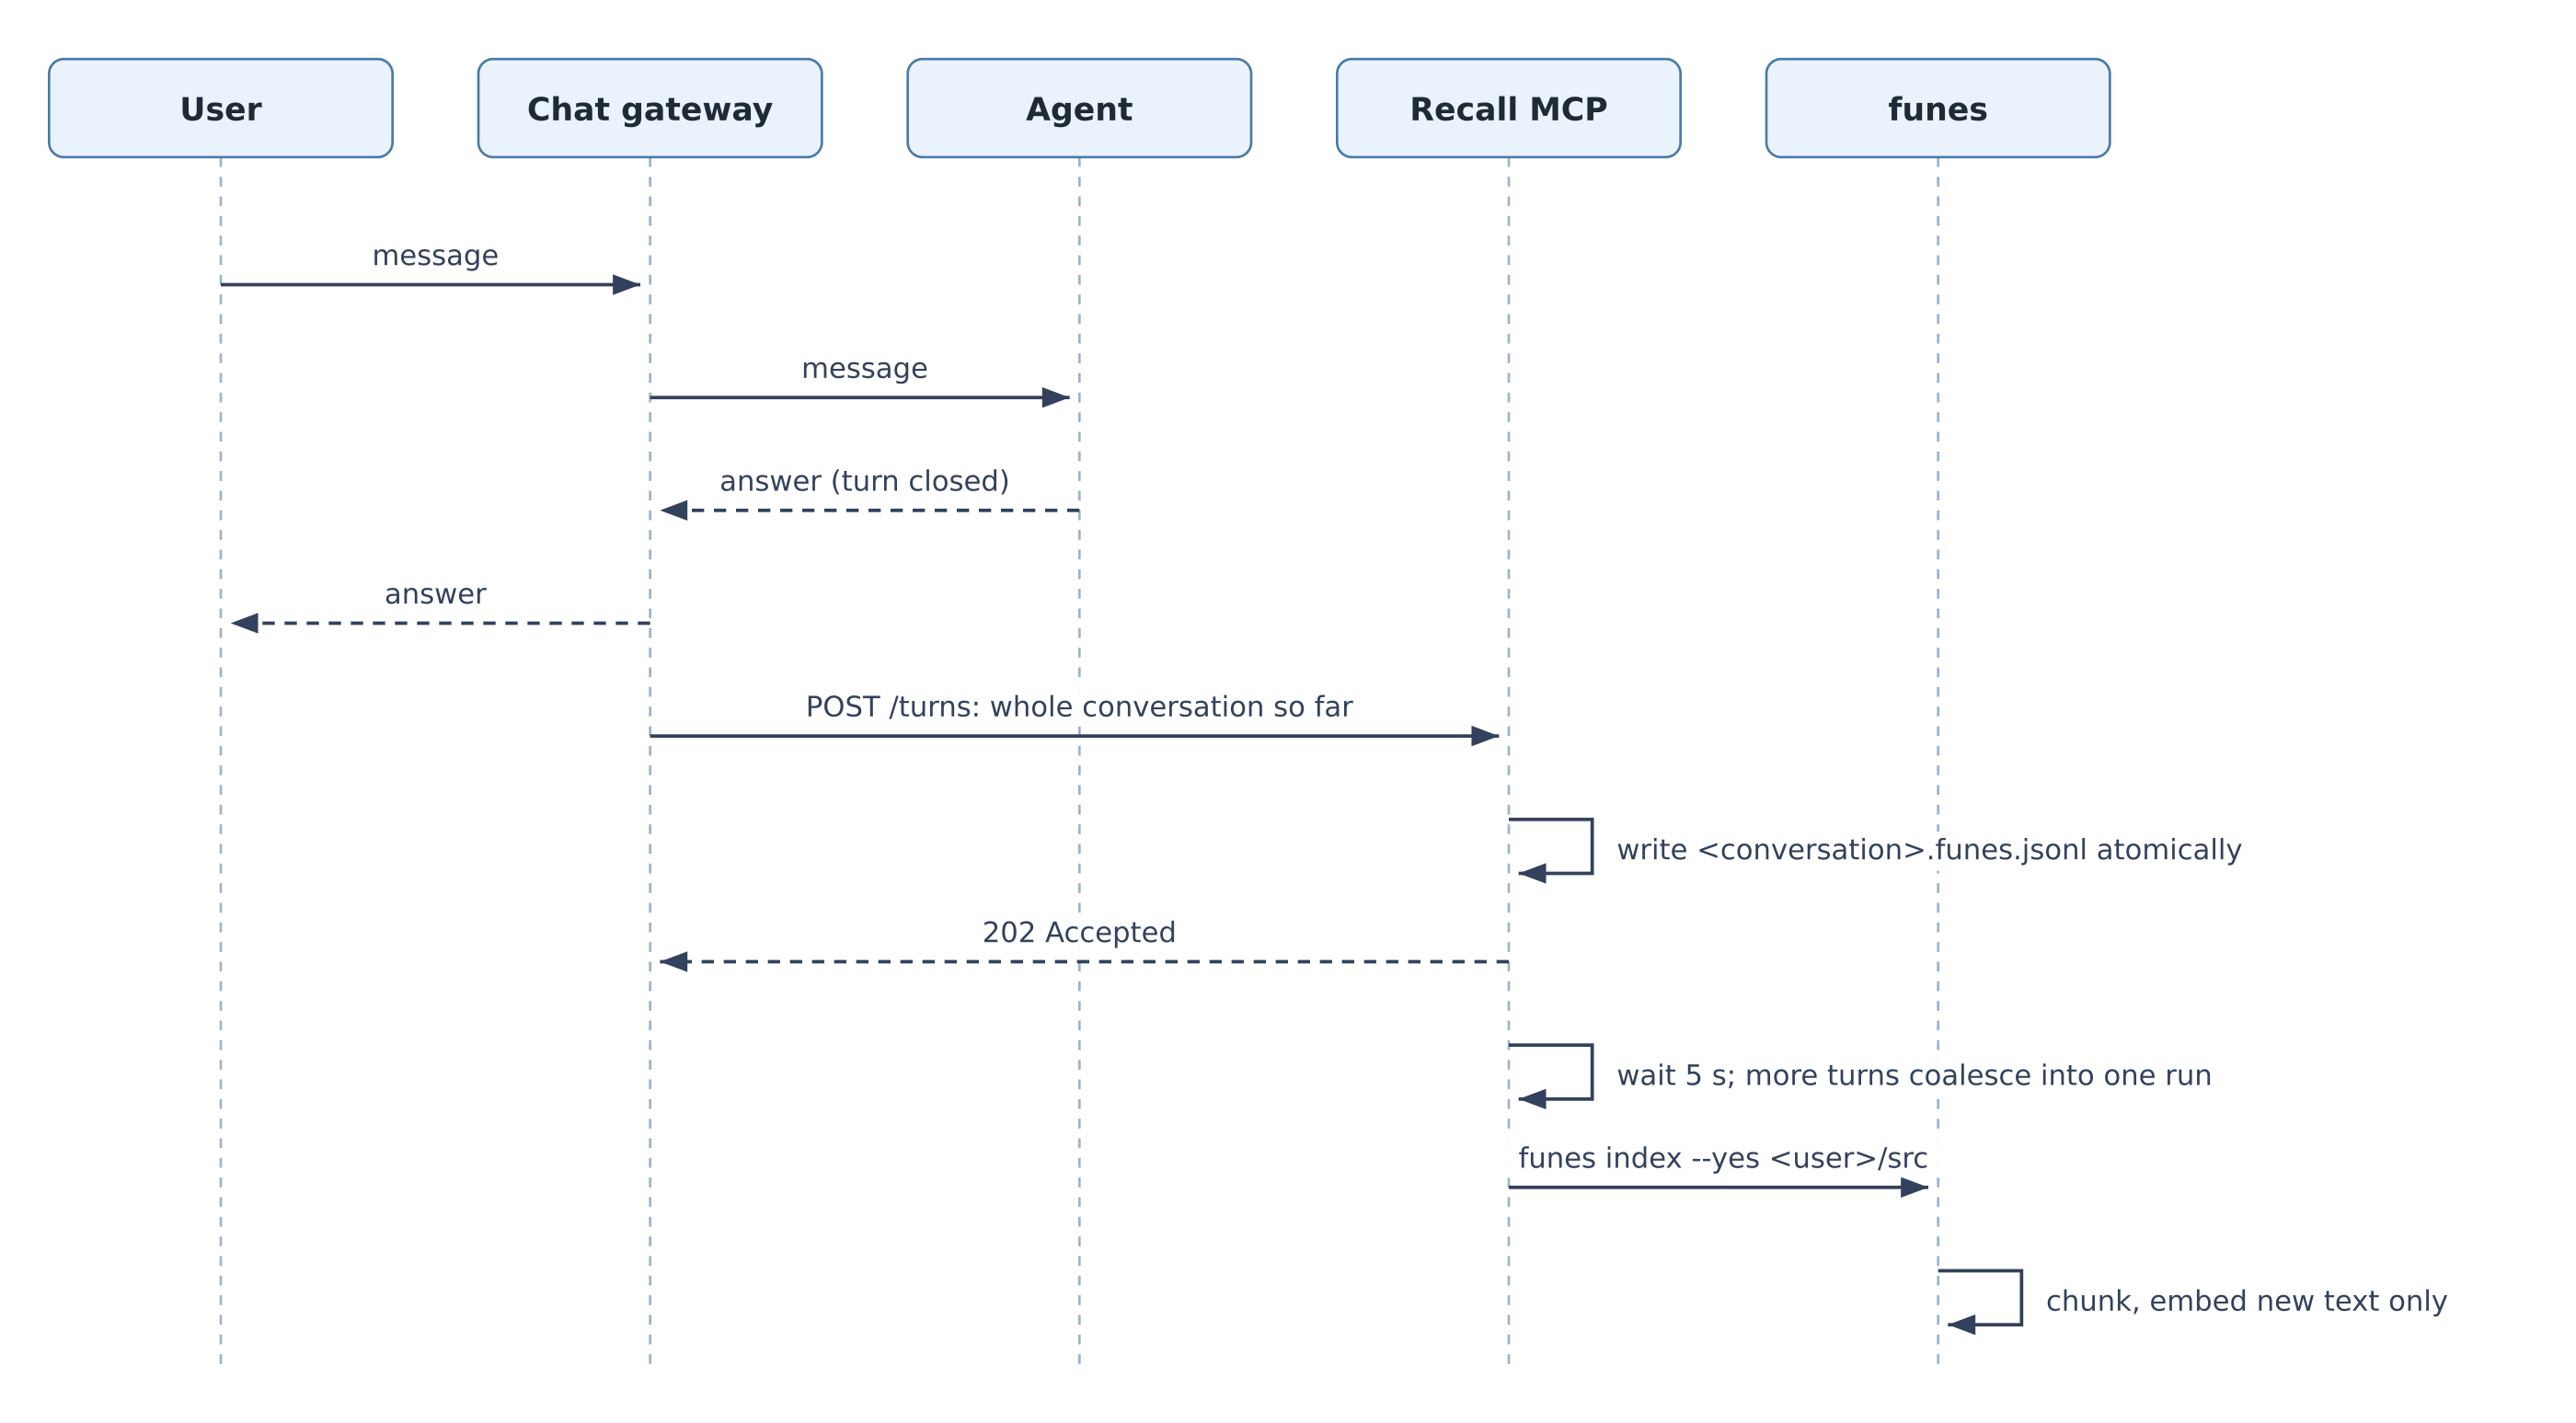
게이트웨이는 매 턴이 끝날 때마다 지금까지의 대화 전체를 전송합니다. 낭비처럼 들리겠지만, 이 덕분에 쓰기가 멱등해집니다. 서버는 대화마다 파일 하나를 원자적으로 다시 쓰고, 이미 임베딩한 것을 추적하는 funes는 새로운 텍스트만 처리합니다.
@mcp.custom_route("/turns", methods=["POST"])
async def ingest(request: Request) -> JSONResponse:
    if not hmac.compare_digest(request.headers.get("x-ingest-key", ""), INGEST_KEY):
        return JSONResponse({"error": "unauthorized"}, status_code=401)
    body = await request.json()
    user, cid = body.get("user"), body.get("conversation_id", "")
    if not user or not re.fullmatch(r"[A-Za-z0-9_-]{1,128}", cid):
        return JSONResponse({"error": "user and a safe conversation_id are required"}, status_code=400)
    payload = to_funes_jsonl(cid, body.get("turns", []))

    src = home(user) / "src"
    src.mkdir(parents=True, exist_ok=True)
    tmp = src / f".{cid}.tmp"
    tmp.write_text(payload)
    tmp.replace(src / f"{cid}.funes.jsonl")   # atomic: recall never sees half a file
    schedule_index(user)
    return JSONResponse({"stored": cid}, status_code=202)
home(user)는 DATA / sha256(user)[:24]이므로, 디렉터리 이름만으로는 사용자 id를 알 수 없습니다. funes 형식으로의 변환은 몇 줄이면 됩니다.
def to_funes_jsonl(conversation_id: str, turns: list[dict]) -> str:
    lines = []
    for seq, t in enumerate(turns):
        ts = datetime.fromisoformat(t["ts"].replace("Z", "+00:00")).astimezone(timezone.utc)
        lines.append(json.dumps({
            "session_id": conversation_id, "turn_uuid": t.get("id") or f"{conversation_id}-{seq}",
            "seq": seq, "ts": ts.strftime("%Y-%m-%dT%H:%M:%SZ"), "role": t["role"],
            "harness": "copilot", "blocks": [{"block_type": "text", "text": t["text"]}],
        }))
    return "\n".join(lines) + "\n"
인덱싱은 사용자별로 디바운스됩니다. 턴이 몰려와도 funes index 실행은 한 번뿐이고, 같은 디렉터리에 대해 두 개의 실행이 동시에 돌아가는 일은 없습니다. 실행 중에 도착한 쓰기는 딱 한 번의 추가 실행만 예약합니다.
def schedule_index(user: str) -> None:
    st = index_state.setdefault(user, {"task": None, "dirty": False})
    st["dirty"] = True
    if st["task"] is None or st["task"].done():
        st["task"] = asyncio.create_task(index_loop(user))

async def index_loop(user: str) -> None:
    st = index_state[user]
    while st["dirty"]:
        await asyncio.sleep(INDEX_DEBOUNCE)
        st["dirty"] = False
        await funes(user, "index", "--yes", str(home(user) / "src"), timeout=300)
리콜은 인덱싱을 기다리지 않습니다. 턴은 끝난 지 몇 초 뒤면 검색 가능해집니다. 어차피 검색 도구에게 “방금 뭐라고 했지?“를 물어보는 사람은 없으니 이걸로 충분합니다.
읽기 경로: 도구 하나
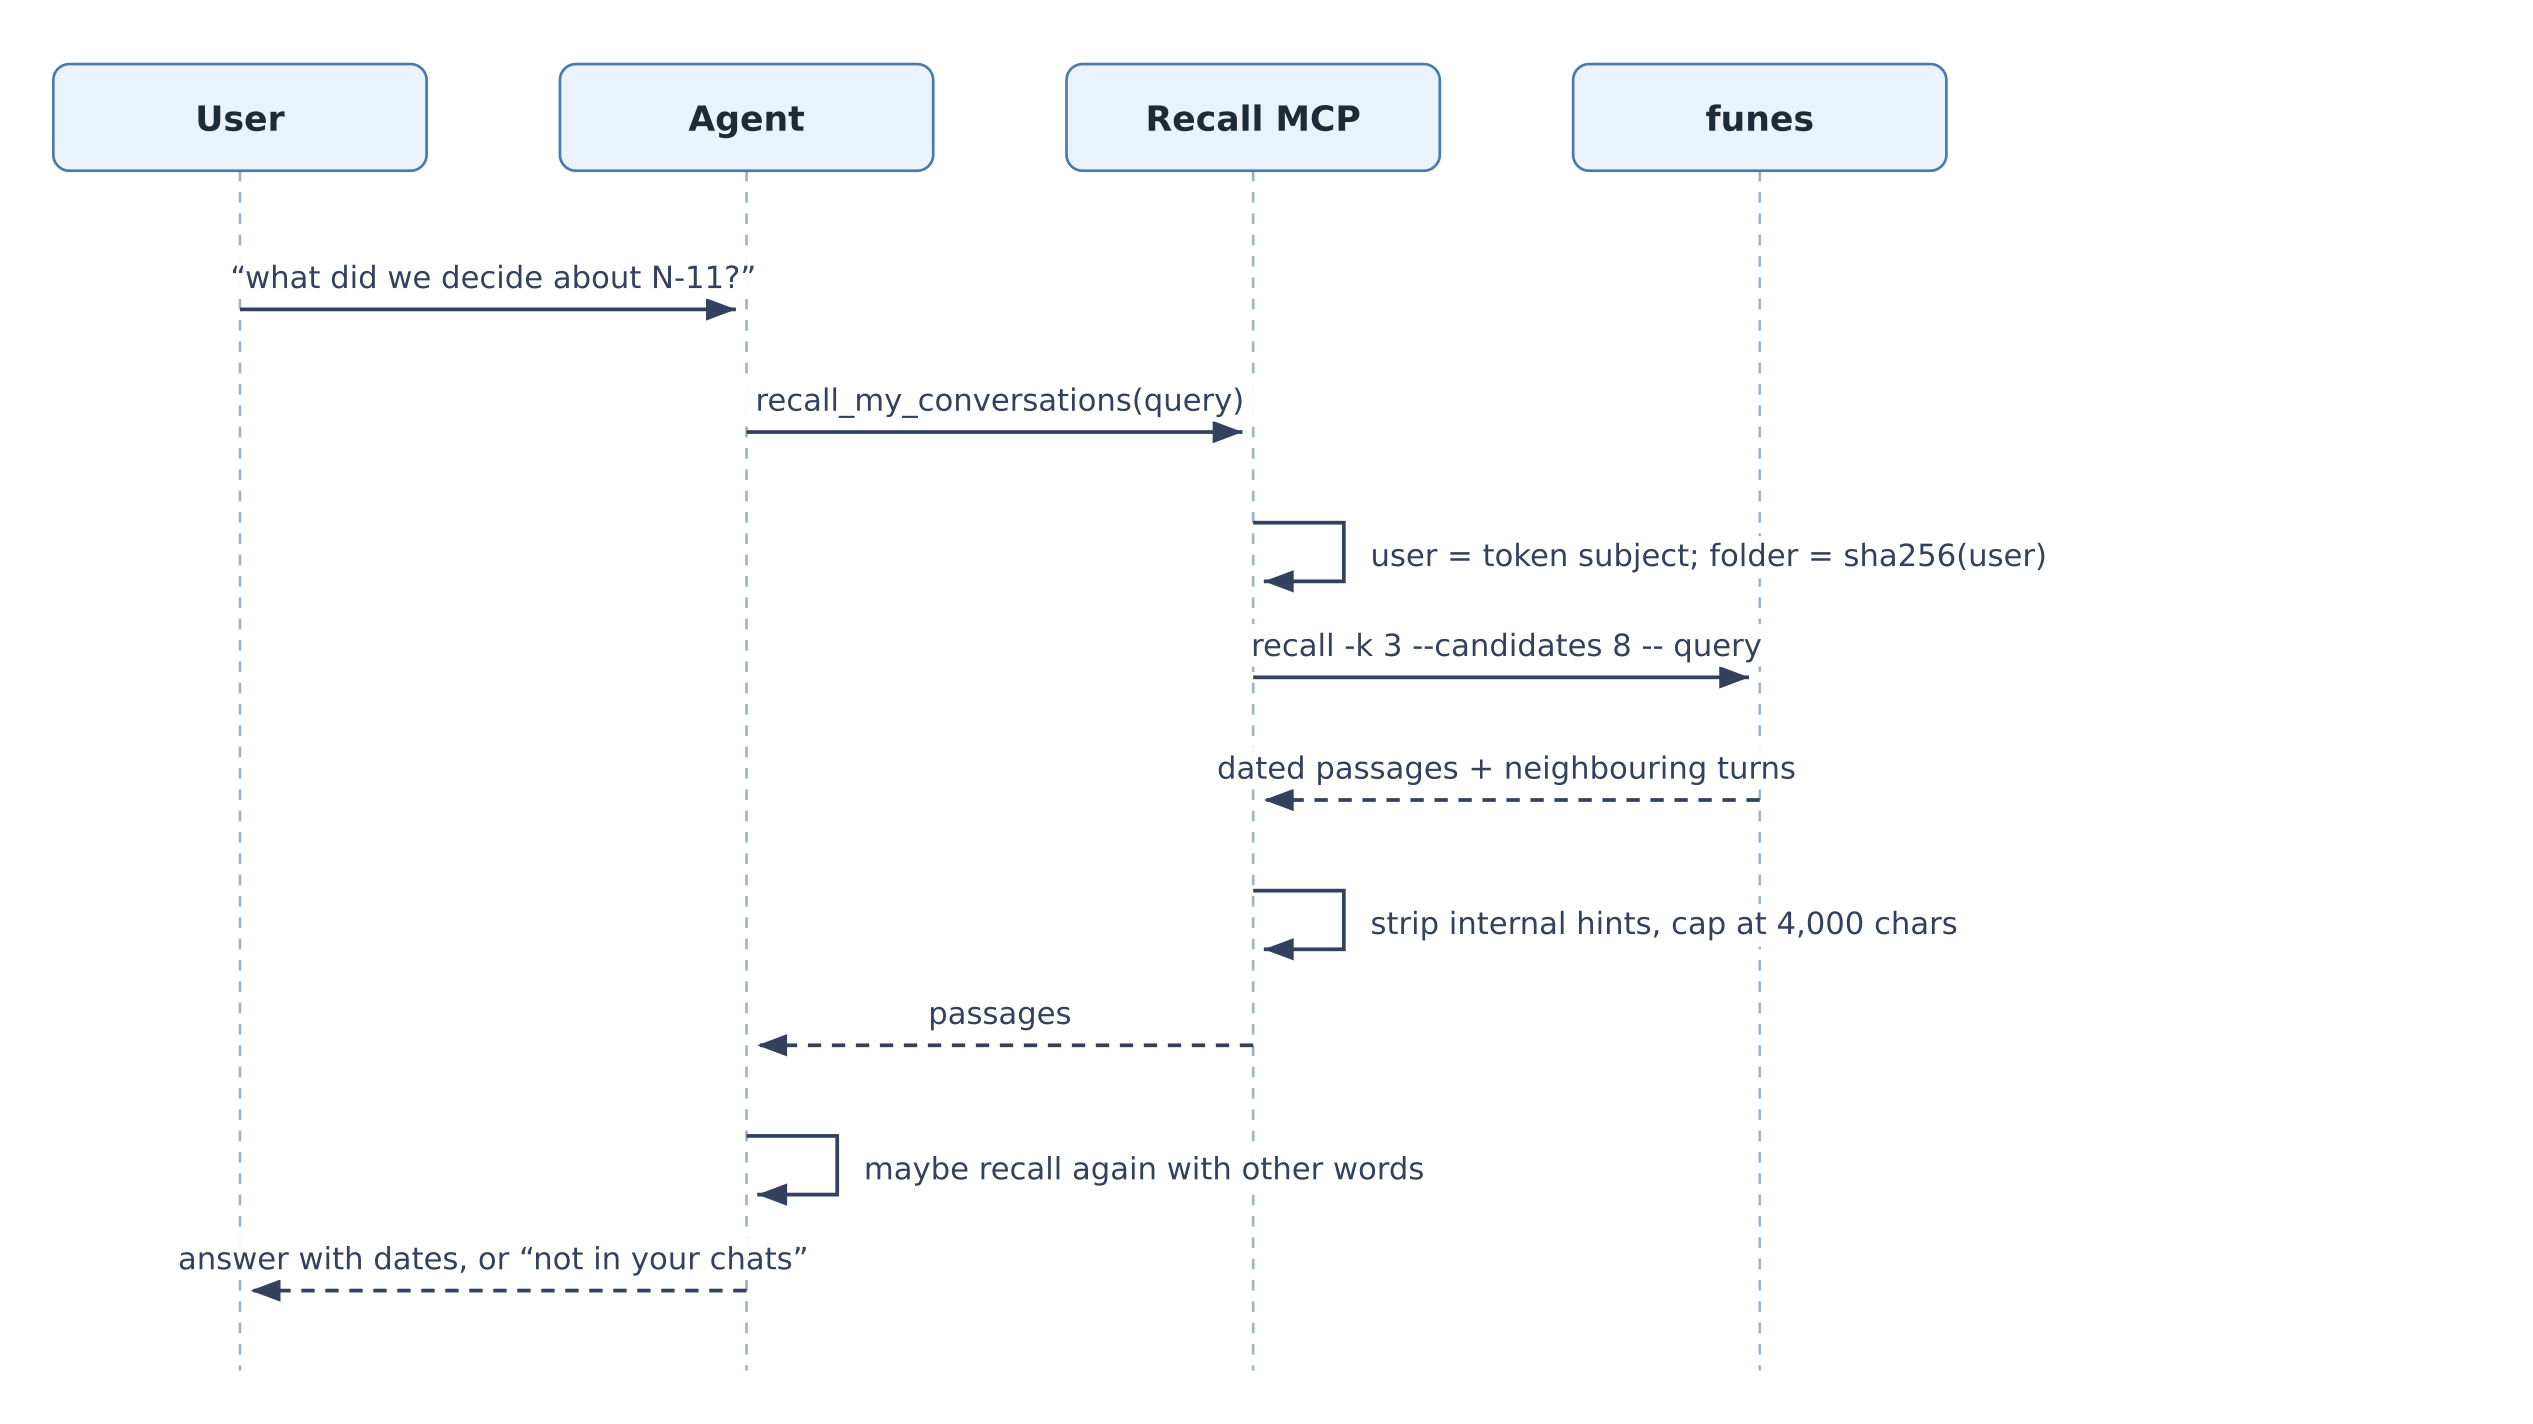
@mcp.tool
async def recall_my_conversations(query: str) -> str:
    """Search the current user's own earlier conversations with this assistant.
    Use it when the user refers to something discussed before ("last time", "earlier",
    "what did we decide", "the numbers we used"). Use short queries built around identifiers
    and key nouns ("K-2 machine ticket"); search again with other words if needed.
    Returns dated passages from past chats. Quote them; do not invent details."""
    user = get_access_token().client_id          # from the verified token, never from the query
    if not (home(user) / "memory").exists():
        return "No earlier conversations are stored for this user yet."
    async with recall_slots:
        code, out = await funes(user, "recall", "-k", str(RECALL_K),
                                "--candidates", str(RECALL_CANDIDATES), "--", query[:500],
                                timeout=RECALL_TIMEOUT)
    if code != 0:
        return "Conversation memory is unavailable right now; continue without it."
    out = HINT_LINE.sub("", out).strip()         # drop funes' "→ get <session> --memory <path>" hints
    return out[:MAX_RESULT_CHARS] or "Nothing relevant found in earlier conversations."
겉보기보다 중요한 세부사항이 몇 가지 있습니다.
- docstring이 방아쇠이자 사용 설명서다. 에이전트는 설명이 사용자의 말투와 맞아떨어질 때 도구를 호출합니다. “지난번”, “전에”, “뭘로 결정했지” 같은 게 사람들이 실제로 쓰는 말입니다. 설명에는 쿼리 작성법도 담겨 있습니다. 짧고 식별자 위주인 쿼리가 더 높은 순위를 받기 때문입니다(측정 결과 참고).
- 쿼리 앞의
--.-k 100이라고 입력한 사용자는 그 텍스트를 검색하려는 것이지, 플래그를 넘기려는 게 아닙니다. - 힌트 줄은 제거한다. funes는 각 히트 뒤에
get을 호출할 수 있는 에이전트를 위해→ get <session> --memory <path>를 출력합니다. 저희 에이전트는get을 호출할 수 없으므로, 이 줄은 답변에 서버 경로와 세션 id만 흘려보낼 뿐입니다. 첫 시험에서 정확히 이런 일이 일어나, 에이전트가 대화 id 접두사를 인용하기 시작했습니다. - 부드럽게 실패한다. 기억에 문제가 생겨도 대화가 끊어져서는 절대 안 됩니다. 도구는 기억을 쓸 수 없다고 말하고, 에이전트는 계속 이어갑니다.
- 비용에 상한을 둔다. 동시 리콜은 최대 4건, 타임아웃은 10초, 컨텍스트에 들어가는 글자 수는 4,000자가 상한입니다.
funes 호출 자체는 환경을 비운 채로 실행됩니다. FUNES_HOME은 사용자 디렉터리로 설정하고, HF_HUB_OFFLINE=1을 세우고, 모델은 이미지에 구워 넣은 디렉터리에서 읽습니다.
패키징: 컨테이너 하나
FROM python:3.12-slim

ARG FUNES_VERSION=1.8.0
ARG FUNES_SHA256=3c7eacbaa4487d253f8e13ef7223325ba05069fc258533db6e19bb5765181fea
ADD --checksum=sha256:${FUNES_SHA256} --chmod=0755 \
    https://github.com/huggingface/funes/releases/download/v${FUNES_VERSION}/funes-x86_64-linux /usr/local/bin/funes

# Bake the embedder: a throwaway index + recall downloads exactly what funes needs.
ARG BAKE_RERANKER=0
ENV HF_HOME=/opt/hf
RUN mkdir -p /tmp/warm/src \
 && echo '{"session_id":"warm","turn_uuid":"t0","seq":0,"ts":"2026-01-01T00:00:00Z","role":"user","harness":"copilot","blocks":[{"block_type":"text","text":"warm up"}]}' > /tmp/warm/src/w.funes.jsonl \
 && FUNES_HOME=/tmp/warm/home funes index --yes /tmp/warm/src \
 && FUNES_HOME=/tmp/warm/home funes recall -k 1 --candidates 2 warm \
 && if [ "$BAKE_RERANKER" = 1 ]; then FUNES_HOME=/tmp/warm/home funes recall -k 1 --candidates 8 warm; fi \
 && rm -rf /tmp/warm && chmod -R a+rX /opt/hf

RUN pip install --no-cache-dir fastmcp==4.1.0
WORKDIR /app
COPY recall_server.py .
RUN useradd -u 10001 -m app && mkdir -p /data/memories && chown app /data/memories
USER app
ENV HF_HUB_OFFLINE=1
CMD ["python", "recall_server.py"]
services:
  recall-mcp:
    build: .
    ports: ["8000:8000"]
    environment:
      INGEST_KEY: ${INGEST_KEY:-demo-ingest-key}
      RECALL_K: "3"
      RECALL_CANDIDATES: "8"
    volumes:
      - memories:/data/memories
volumes:
  memories:
따라 할 만한 트릭은 워밍업 단계입니다. 모델 파일을 하드코딩하는 대신, 빌드가 작은 인덱싱 한 번과 리콜 한 번을 실행해서 funes가 실제로 쓰는 모델만 정확히 HF_HOME으로 다운로드하게 합니다. 런타임에서 컨테이너는 Hugging Face Hub에 전혀 접속하지 않습니다. 이미지 레이어 크기는 funes 바이너리가 218MB, 임베딩 모델이 134MB, FastMCP가 119MB입니다. 리랭커를 구워 넣으면 1.13GB가 더 붙는데, 이것도 꺼두는 이유 중 하나입니다. 별도의 RUN chmod를 쓰면 218MB짜리 바이너리가 두 번째 레이어로 복사되므로, ADD --chmod를 쓰세요.
실제로 되는가? 어느 운영 리더의 2주
기억에는 몇 개의 현장을 운영하는 사람이 2주 동안 나눴을 법한 대화 여섯 개를 씨앗으로 심었습니다. 두 현장의 실적 검토, 예산을 위한 예측 계산, 야간 배치 작업 상태 점검, 교대 인수인계, 단위 비율 계산, 용량 점검입니다. 이 예시들은 허구이고 일부러 일반적으로 만들었습니다. ID, 담당자, 티켓, 숫자만 있으면 어떤 도메인이든 리콜 입장에서는 똑같이 보입니다. 두 번째 사용자 bob에게는 다른 현장에 대한 대화 하나를 주었습니다. 시더는 채팅 게이트웨이 역할을 하며, 프로덕션과 똑같이 매 턴이 끝날 때마다 대화를 전송합니다.
에이전트로는 헤드리스 모드의 Claude를 썼고, 이 서버를 유일한 도구로 주었으며 도메인에 대한 다른 지식은 전혀 주지 않았습니다.
claude -p "$QUESTION" --strict-mcp-config --mcp-config mcp-alice.json \
  --tools "" --allowedTools mcp__recall__recall_my_conversations \
  --system-prompt "$(cat system.md)"
아래의 모든 답변은 에이전트가 리콜한 구절만으로 만들어낸 것입니다.
두 대화에 걸친 결정과 그 블로커. “N-11 업그레이드에 대해 뭘로 결정했지? 일정을 잡기 전에 뭐가 끝나야 하지? 내 메모에 따르면 그 블로커는 아직 안 풀렸나?” 에이전트는 네 번 리콜(N-11 upgrade, N-11 blocker schedule, MT-4471 K-2 machine, K-2 closed)을 하고 이렇게 답했습니다.
결정(2026-10-08): N-11 업그레이드 제안을 진행하기로 결정했습니다. 부하 91%는 “받아들일 만하지만 빠듯하다"고 말씀하셨습니다. 업그레이드 후 North 마감 라인의 예상 부하는 2,400대/일 중 약 2,185대/일(91%)입니다. 일정을 잡기 전에: 유지보수 티켓 MT-4471(K-2 기계 문제)을 먼저 해결해야 합니다. 그 블로커는 아직 열려 있나요? 제 메모에는 해결됐다는 기록이 없습니다. […] 2026-10-08 이후로 MT-4471이 해결되거나 닫혔다는 내용은 찾지 못했습니다. […] 일정을 잡기 전에 유지보수 시스템에서 티켓을 확인하세요.
결정은 10-08 대화에서, 티켓 상세 내용은 10-03 인수인계에서 나온 것입니다. 에이전트는 이 둘을 연결했고, 메모에 없는 내용에 대해서는 정직했습니다.
두 대화에 걸쳐 찾아낸 원인. “9월 말에 정산 컬럼이 비어 있었던 이유가 뭐였지? 그리고 그걸 누구한테 에스컬레이션했지?” 한 대화에서 사용자는 빈 컬럼을 발견하고 Tomas에게 물어볼 계획이라고 적었습니다. 이후의 대화에서는 두 건의 작업 실패가 데이터 피드 F-204로 거슬러 올라갔습니다. 두 번의 리콜로 에이전트는 이 둘을 연결했습니다. 작업이 실패한 건 F-204 피드 결손 때문이었고, 문제는 통합 담당 리더인 Priya에게 전달되었습니다. 에이전트는 대화에 기록된 건 에스컬레이션하겠다는 계획뿐이며, 두 건의 작업 실패(09-26 이후)가 09-23부터 09-25까지의 빈 날짜를 설명하지는 못한다고도 덧붙였습니다. 또한 리콜된 텍스트에서 정확한 에러 메시지가 잘려 있다고도 말했습니다. 이건 사실입니다. funes는 주변 턴을 짧은 미리보기로 반환하고, 에이전트는 빈칸을 채워 넣는 대신 그 사실을 그대로 말했습니다.
여러 대화를 가로지르는 할 일 목록. “지금까지의 모든 대화에서 아직 안 끝난 후속 작업을 하나로 모은 목록을 줘.” 다섯 번의 리콜에서 다섯 개의 서로 다른 대화로부터 일곱 개의 항목이 나왔고, 각각에 담당자, 기한, 출처 날짜가 붙어 있었습니다. 에이전트는 오늘 날짜와 비교해 기한이 지난 항목에 표시를 하고, 두 항목이 근본적으로 같은 문제라는 점을 짚어냈고, 요일을 날짜로 바꾼 부분(“대화에는 그냥 목요일이라고만 적혀 있습니다”)에는 표시를 남겨 사용자가 확인할 수 있게 했습니다.
정확한 숫자. “베이스 케이스로 고른 예측 시나리오는 뭐였지? 파라미터는? 18개월 시점 값은?” 쌍곡선형, q0는 1,500대/일, Di는 0.25/년, b는 0.6이었고, 18개월 시점에서 1,069.5대/일, 693.3천 대였으며 비교용으로 지수형 시나리오도 함께 제시했습니다. 숫자는 원래 계산과 정확히 일치했고, 에이전트는 대화에 결정은 기록되어 있지만 그 이유는 기록되어 있지 않다고 덧붙였습니다.
네거티브 컨트롤과 격리. “모터 P-7이나 티켓 MT-5120에 대해 얘기한 적 있나?” alice로 물으면: “아니요. 제가 검색할 수 있는 이전 대화 중에는 모터 P-7이나 티켓 MT-5120에 관한 게 없습니다.” 그리고 혼동했을 법한 가장 가까운 후보(기계 K-2, 티켓 MT-4471)를 제시했습니다. bob으로 같은 질문을 하자, P-7 베어링 소음과 티켓 MT-5120이 언급된 그의 South 허브 대화가 돌아왔습니다. 단어가 정확히 일치해도 alice는 bob의 이력을 볼 수 없습니다. alice의 토큰은 언제나 alice 자신의 디렉터리만 열기 때문입니다.
에이전트 실행은 처음부터 끝까지 411초가 걸렸고, 리콜 호출은 각각 25회였습니다. 그중 리콜이 차지하는 시간은 약 1초입니다. 전체 답변은 examples/agent-runs.md에 있습니다.
프로덕션에 가까운 스택에서도 같은 결과
데모를 쓰기 전에 저희는 같은 설계를 실제 코파일럿에 연결해봤습니다. 상용 에이전트 플랫폼, 저희 자체 채팅 게이트웨이, Java MCP 서버, 그리고 같은 컨테이너 안의 funes입니다. 네 개의 실무 대화(데이터 조회, 계산, 인수인계 메모)에 이어, 새 대화에서 네 개의 리콜 대화를 진행했습니다. 에이전트는 13번 리콜을 호출했습니다. 리콜된 사실은 전부 정확했습니다. 리콜한 파라미터로 더 긴 기간의 예산 시나리오를 재계산한 것과, 한 번도 언급된 적 없는 장비에 대한 네거티브 컨트롤까지 포함해서요. 리콜된 세부사항 하나는, 테스트 드라이버가 중간에 포기해버린 스트림의 답변에서 나온 것이었습니다. 게이트웨이는 그래도 완료된 턴을 전달했고, 기억은 테스트 하네스보다 더 많이 알고 있었습니다.
측정 결과
골라낸 예시를 넘어서기 위해, 한 사용자에 대한 합성 이력을 생성했습니다. 메시지 6개로 된 대화를 N개 만들고, 각각에 확인 가능한 사실(티켓 번호, 품질검사 불합격률, 작업 담당자, 혹은 결정 참조 중 하나) 하나를 잡담 속에 숨겼습니다. 혼동 요소는 의도적으로 넣었습니다. 모든 현장과 장비는 약 여섯 개의 대화에(잡담 속에서나 다른 사실의 일부로) 등장하고, 같은 12명의 사람, 작업 유형, 증상이 곳곳에서 반복되므로 쿼리는 조합에 맞아야 하고 희귀 단어 하나에 의존할 수 없습니다. 각 질문의 정답은 정확히 하나입니다. 질문은 다르게 표현되어 있습니다. 사실에는 “티켓 MT-1040이 열려 있다"고 적혀 있지만, 질문은 “펌프 P-003의 실 누출에 대해 올라간 작업 지시 번호는?“이라고 묻습니다. 히트란 도구가 반환하는 텍스트 안에 기대 답변이 나타나는 것을 뜻합니다.
모든 것은 4 CPU, 4GB로 제한된 컨테이너 안에서, 호출마다 새로운 funes 프로세스 하나로 실행했습니다. 서버가 실제로 돌아가는 방식 그대로입니다.
| 대화 1,000개 | 대화 3,000개 | 대화 10,000개 | |
|---|---|---|---|
| 메시지 수 / 원본 텍스트 | 6,000 / 1.5 MB | 18,000 / 4.5 MB | 60,000 / 14.9 MB |
| 리콜, k=3, 풀 8(채택 설정): 적중률 | 91% / 93% | 93% / 95% | 100% / 97% |
| 동일 조건, 짧은 에이전트식 쿼리 | 94% | 95% | 98% |
| 리콜, k=8, 풀 8: 적중률 | 100% | 100% | 100% |
| 리랭크 적용 리콜, k=3, 풀 32: 적중률 | 99% | 99% | 100% |
| 리콜 지연 시간 p50 / p95(리랭크 없음) | 0.15–0.20 / 0.22 s | 0.16–0.19 / 0.23 s | 0.18–0.19 / 0.24 s |
| 리콜 지연 시간 p50(리랭크) | 3.1 s | 3.0 s | 3.1 s |
| 리콜당 피크 메모리 | 231 MB(리랭크 시 1.64 GB) | 234 MB(1.65 GB) | 240 MB(1.66 GB) |
| 대화 1건 추가(증분 인덱싱) | 1.2–1.8 s, 270 MB | 8–9 s, 305 MB | 4.5–4.8 s, 390–400 MB |
| 처음부터 인덱싱(백필) | 68–70 s, 650 MB | 242 s, 1.26 GB | 19.5분, 1.9 GB |
| 디스크상의 기억 디렉터리 크기 | 86 MB | 605 MB | 424 MB |
각 규모마다 질문 100개, 4 CPU. 셀에 값이 두 개 있는 경우는 매번 완전 재인덱싱을 거쳐 벤치마크를 두 번 돌린 것입니다. 그 차이는 인덱스 빌드의 실행 간 편차입니다.
수치가 말해주는 것:
- 리콜 지연 시간은 이력 크기에 좌우되지 않는다. 리콜 1회는 대화가 1,000개든 10,000개든 약 0.2초, 240MB가 듭니다. 그 대부분은 프로세스 시작과 임베딩 모델 로딩입니다. 규모 감각을 위해: 하루에 대화 10건을 나누는 엔지니어라면 연간 약 2,500개의 대화가 쌓입니다.
- 질문이 사라지는 게 아니라, 컷오프 아래로 밀릴 뿐이다. 세 개 대신 여덟 개의 구절을 반환하게 하면, 모든 규모에서 모든 질문이 적중했습니다. 세 개로는 최대 9%의 질문을 놓쳤습니다. 놓친 사례를 살펴보니 공통 원인이 하나 있었습니다. 다른 장비에 대한 거의 동일한 사실(“진동 경보가 계속 뜬다"는 K-039, K-019, K-007 각각에 대해)이 정답보다 높은 순위를 차지했는데, 길고 바꿔 표현된 질문이 의미상으로는 그것들과도 일치했고, 구별되는 건 ID뿐이었기 때문입니다. 같은 질문을 “컴프레서 K-047 티켓"으로 줄이면 정답 대화가 1위로 올라왔습니다. 어차피 에이전트가 도구 호출을 쓰는 방식이 그렇습니다(저희 에이전트의 쿼리는
MT-4471 K-2 compressor closed같은 형태였습니다). 그리고 짧은 쿼리는 전반적으로 조금씩 더 높은 점수를 받았습니다. 도구 설명에 “식별자 중심의 짧은 쿼리를 사용하라"는 문구를 추가했습니다. - 리랭커는 k=3의 누락을 되사 오지만, 비싼 값을 치른다. k=3에서 99~100%까지 끌어올렸지만, 지연 시간은 15배, 메모리는 7배, 이미지에는 1.1GB짜리 모델이 추가로 필요합니다. 구절을 더 많이 반환하는 쪽은 지연 시간 비용 없이 같은 정확도를 얻고, 대신 컨텍스트 토큰을 씁니다. k=3을 유지하는 이유는 첫 시도가 질문에 답하지 못하면 에이전트가 다시 질의하기 때문입니다. 여러분의 에이전트가 그렇게 하지 않는다면 k(와 글자 수 상한)를 올리세요.
- 인덱싱은 중요한 곳에서 저렴하다. 새 대화는 요청 경로 바깥에서 몇 초, 수백 MB 안에 검색 가능해집니다. 10,000개 대화 이력을 처음부터 구축하는 데는 20분, 2GB가 듭니다. 이건 한 번뿐인 백필이므로, 서버 안이 아니라 배치 작업으로 실행하세요.
- 디스크 사용량은 적당하지만 선형적이지는 않다. 기억 디렉터리에는 벡터, 전문 검색 인덱스, 테이블 버전이 들어 있습니다. 그 크기는 스토리지 엔진이 얼마나 자주 압축을 수행했는지에 좌우됩니다. 저희 실행에서 3,000개 대화가 10,000개보다 더 많은 공간을 차지한 이유도 이것입니다. 매우 헤비한 사용자에게는 수백 MB를, 일반적인 사용자에게는 몇 MB를 예산으로 잡으세요.
이것은 무엇이고, 무엇이 아닌가
| 이것인 것 | 이것이 아닌 것 |
|---|---|
| 사용자 자신의 과거 대화를 그대로 검색하는 것 | 지식 베이스나 사용자 프로필 |
| 에이전트 주도: 언제 되돌아볼지는 에이전트가 결정 | 매 프롬프트마다 조용히 주입되는 컨텍스트 |
| 에이전트가 인용하고 사용자가 검증할 수 있는, 날짜 붙은 구절 | 출처 없이 추출된 “사실” |
| 사용자별로, 호출자의 토큰으로 격리됨 | 팀이 공유하는 지식(그건 별도의, 의도적인 설계가 필요) |
| 추가 전용 이력 | 대화에서 말하지 않은 한, 티켓이 닫혔다는 걸 아는 것은 아님 |
한계
- 이력은 진실이 아니다. 리콜은 말해진 것을 반환할 뿐이고, 여기에는 실수나 실현되지 않은 계획도 포함됩니다. 저희 에이전트는 이를 잘 다뤘지만(“메모에는 닫혔는지 여부가 적혀 있지 않습니다”), 그건 에이전트와 그 프롬프트 덕분입니다. 도구 자체는 이를 보장할 수 없습니다.
- 리콜한 대화도 기억된다. 리콜 대화에서 나온 답변도 다른 턴과 똑같이 인덱싱됩니다. 보통은 이게 도움이 됩니다. 정리된 할 일 목록도 검색 가능해지니까요. 하지만 틀린 리콜 답변 역시 미래의 “기억"이 되어버립니다. 거의 리콜 출력으로만 이루어진 턴을 제외하는 건 합리적인 개선입니다.
- 삭제는 곧 재구축이다. funes는 추가 전용입니다. “이 대화를 잊어줘"는 원본 파일을 삭제하고 그 사용자의 디렉터리를 재인덱싱한다는 뜻입니다. 사용자 한 명이라면 저렴하지만, 그래도 프라이버시 요청과 보존 정책을 위해 명시적으로 수행해야 하는 작업이라는 사실은 변하지 않습니다.
- 비밀 정보와 개인 데이터도 그대로 남는다. 사용자가 대화에 붙여넣는 건 뭐든 그 사람의 기억에 들어갑니다. 전달하기 전에 게이트웨이에서 마스킹하고, 보존 기간은 미리 정해두세요. (funes에는 비밀 정보용
scrub명령이 있지만, 업무 데이터용은 아닙니다.) - 영어 우선 임베딩. bge-small-en은 영어 모델입니다. BM25는 어떤 언어든 정확한 코드는 그대로 매칭하지만, 다른 언어에서 의미 기반 검색을 하려면 다국어 임베딩 모델이 필요합니다.
- 에이전트의 행동은 일정하지 않다. 요청에 도구 이름이 명시되어 있지 않으면, 되돌아볼지는 에이전트가 직접 판단해야 합니다. 잘 쓰인 도구 설명이 대부분을 해결해줍니다. 시스템 프롬프트의 한 줄(“사용자가 이전 작업을 언급하면, 답하기 전에 리콜할 것”)이 나머지를 채워줍니다.
- 호출마다 프로세스 하나. 단순하고 튼튼하지만, 모든 리콜이 프로세스 시작과 모델 로딩 비용(~0.2초 중 일부)을 치릅니다. 요청 빈도가 매우 높다면, 테넌트별로 장시간 실행되는 funes MCP 서버(
funes mcp <memory>)가 이를 피할 수 있습니다.
마치며
에이전트가 제로에서 시작하는 걸 멈추는 데 뇌 이식 같은 건 필요 없습니다. 필요한 건 이미 일어난 일을 찾아보는 방법입니다. 검색을 funes에 맡기면, 이 기능 전체는 완료된 턴을 저장하는 경로 하나, 호출자의 신원으로 그걸 검색하는 도구 하나, 그리고 버전을 고정한 바이너리와 구워 넣은 모델이 든 컨테이너 하나로 귀결됩니다. 이건 SF적인 의미의 기억이 아닙니다. 리콜입니다. 날짜가 붙고 검증 가능한, 과거에 대한 단서를 에이전트가 필요할 때 요청하는 것입니다. 에이전트를 쓰는 사람 입장에서는, “N-11이 뭐였는지 알려줘"와 “MT-4471이 닫힌 다음에 진행하기로 결정하셨어요. 아직 안 닫혔습니다” 사이의 차이입니다.
완전한 데모(서버, Dockerfile, compose 파일, 시드용 대화, 에이전트 래퍼, 벤치마크)는 함께 제공되는 저장소에 있습니다.