어느 월요일, 저희가 쓰던 클라우드 검색 서비스가 꺼졌습니다. 돌아올 날짜도 없었습니다. 에이전트의 도구 두 개가 그 위에 올라가 있었습니다. 하나는 질문에 맞는 데이터베이스 테이블을 찾고, 다른 하나는 제품 문서를 검색합니다. 이 도구들이 없어도 에이전트는 여전히 답을 했지만, 그 답은 기억에서 나온 것이었고, 문서 검색 도구가 막아야 하는 바로 그 상황이었습니다.
선택은 두 가지였습니다. 기다리거나, 로컬 대체재를 만들거나. 저희는 하루 만에 만들었습니다. 에이전트의 도구 서버 옆에서 작은 컨테이너로 돌아가고, 클라우드 계정이 필요 없으며, 시작하는 데 약 1초가 걸립니다. 하루 뒤 클라우드 인덱스가 돌아왔고, 그제야 미뤄두었던 일을 할 수 있었습니다. 같은 질문들을 두 시스템에 똑같이 던져서 얼마나 차이 나는지 보는 일 말입니다.
이 글은 MCP 위에서의 에이전트 도구화를 다루는 연재를 이어갑니다. 첫 번째 글은 에이전트에게 Python을 위한 샌드박스를 마련해주었고, 두 번째 글은 행 대신 참조를 넘겼고, 세 번째 글은 테이블 조회에 작은 결정 모델을 써봤고, 네 번째 글은 에이전트에게 지난 대화를 검색할 수 있는 리콜 기능을 주었습니다. 그 글은 funes를 썼고, funes는 인덱스를 Lance 형식으로 저장합니다. 여기서 Lance가 다시 등장합니다.
“로컬 RAG"가 대신해야 하는 것
매니지드 검색 서비스는 네 가지를 대신해줍니다.
- 키워드 검색(BM25), 어간 추출과 필드 가중치 포함.
- 벡터 검색, 인덱싱과 쿼리 시점에 대신 호출해주는 임베딩 모델과 함께.
- 두 목록의 융합(하이브리드 검색), 그리고 선택적으로 그 위에 리랭커.
- 운영: 스토리지, 스케일링, API, 키.
앞의 세 가지는 Python 프로세스 하나에 들어갑니다. 네 번째는 코퍼스가 매 릴리스마다 바뀌는, 분 단위가 아니라 몇천 개 문서 규모일 때는 대부분 필요 없어집니다. 저희 문서는 약 2,100개의 마크다운 페이지(화면 도움말, 기술 노트, 사용법, 릴리스 노트)이고, 이는 9,000개의 패시지(passage)가 됩니다. 작은 규모입니다. 노트북 CPU로 충분합니다.
스택
| 역할 | 선택 | 이유 |
|---|---|---|
| 스토리지, BM25, 벡터 검색 | LanceDB 0.41 | 임베디드 라이브러리 하나로 두 종류의 검색을 모두 처리, 디스크 위의 파일, 서버 없음 |
| 임베딩 | BAAI/bge-small-en-v1.5 (fastembed 경유) | 384차원, CPU에서 ONNX, 3,300만 파라미터 |
| 리랭커(선택) | jinaai/jina-reranker-v1-turbo-en (fastembed 경유) | 작은 크로스 인코더, 역시 CPU |
| 에이전트 인터페이스 | MCP 도구(FastMCP) 또는 평범한 HTTP 라우트 | 에이전트가 이미 호출하는 방식 그대로 |
GPU도, 모델 API도, 벡터 데이터베이스 서버도 없습니다. 모델은 이미지를 빌드할 때 한 번 내려받고, 컨테이너는 오프라인으로 돌아갑니다.
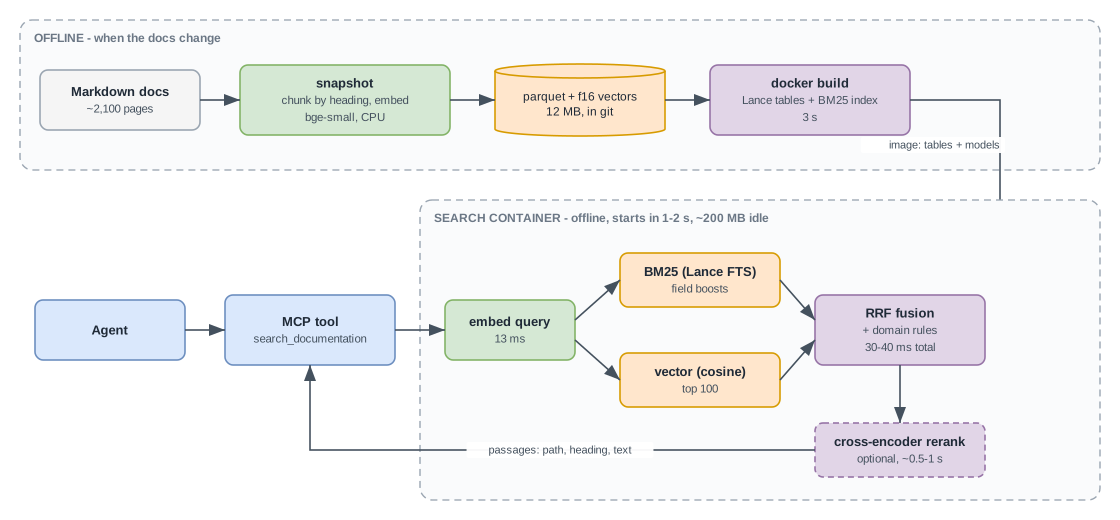
1단계: 청크로 나누고 인덱싱하기
각 페이지를 ##/### 헤딩에서 잘라내고, 헤딩 경로를 패시지와 함께 보관합니다. 헤딩 기준 청크가 고정 길이 윈도우보다 나은 이유는, 도움말 페이지의 섹션들이 보통 각각 하나의 질문에 답하고, 헤딩이 작성자가 준 가장 좋은 요약이기 때문입니다.
def chunks(root, max_chars=1600):
    for path in sorted(Path(root).rglob("*.md")):
        text = path.read_text(errors="ignore")
        title = next(iter(re.findall(r"^# (.+)$", text, re.M)), path.stem)
        for section in re.split(r"\n(?=#{2,3} )", text):
            heading = section.splitlines()[0].lstrip("# ").strip() if section.startswith("#") else ""
            for i in range(0, len(section), max_chars):
                yield {"path": str(path.relative_to(root)), "title": title, "heading": heading, "text": section[i:i + max_chars]}


def build(root, data_dir):
    rows = list(chunks(root))
    embedder = TextEmbedding("BAAI/bge-small-en-v1.5")
    vectors = embedder.embed([f"{r['title']} > {r['heading']}\n{r['text']}" for r in rows], batch_size=64)
    for r, v in zip(rows, vectors):
        r["vector"] = v.tolist()
    table = lancedb.connect(data_dir).create_table("docs", data=rows, mode="overwrite")
    table.create_fts_index("text", use_tantivy=False, language="English", stem=True, remove_stop_words=True)
제목과 헤딩을 텍스트와 함께 임베딩합니다. “레코드를 추가하려면 Insert를 누르세요"라는 패시지는, 위에 “장비 다운타임 > 이벤트 입력"이 없으면 아무 의미가 없습니다.
2단계: reciprocal rank fusion으로 하는 하이브리드 검색
두 검색을 모두 돌리고, 점수가 아니라 순위로 합칩니다. BM25 점수와 코사인 거리는 서로 다른 척도에 있고, reciprocal rank fusion(RRF)은 이를 보정할 필요를 없애줍니다. 각 목록은 문서에 1 / (60 + rank)를 주고, 그 합이 결정합니다.
def search(self, query, k=5):
    vec = next(iter(self.embedder.embed([QUERY_PREFIX + query])))
    keyword = self.table.search(query, query_type="fts").with_row_id(True).limit(50).to_list()
    semantic = self.table.search(vec).distance_type("cosine").with_row_id(True).limit(50).to_list()
    scores, rows = {}, {}
    for hits in (keyword, semantic):
        for rank, r in enumerate(hits):
            scores[r["_rowid"]] = scores.get(r["_rowid"], 0) + 1 / (60 + rank + 1)
            rows[r["_rowid"]] = r
    top = [rows[i] for i in sorted(scores, key=scores.get, reverse=True)[:max(k, 10)]]
    if self.reranker:
        ce = list(self.reranker.rerank(query, [f"{r['title']} > {r['heading']}\n{r['text'][:1000]}" for r in top]))
        top = [r for _, r in sorted(zip(ce, top), key=lambda p: -p[0])]
    return top[:k]
QUERY_PREFIX는 bge 모델이 쿼리 쪽에서 학습할 때 쓴 지시문입니다(“Represent this sentence for searching relevant passages: “). 패시지는 이것 없이 임베딩됩니다.
3단계: 도구로 노출하기
mcp = FastMCP("local-docs")

@mcp.tool
def search_documentation(query: str, k: int = 5) -> list[dict]:
    """Search the product documentation. Returns passages with file path and heading; cite the path."""
    return search(query, min(k, 10))

mcp.run(transport="http", host="0.0.0.0", port=8080)
이게 범용 버전의 전부입니다. 약 90줄이고, 300페이지 샘플(686개 패시지를 노트북에서 70초에 인덱싱, 리랭커를 켠 상태로 도구 호출당 0.5~0.7초)로 테스트했습니다.
4단계: 여러분만의 몫
범용 파이프라인이 대부분을 해결해줍니다. 나머지는 라이브러리가 아니라 평가 세트에서 나왔습니다. 저희 프로덕션 버전에서 숫자를 바꾼 것들은 다음과 같습니다.
- 구조화된 필드는 각자의 가중치를 받습니다. BM25는 여러 필드에 걸쳐 돌아갑니다:
title×3, 페이지 이름과 코드 ×3,headings×2,text×1. - 쿼리 속 코드는 정확한 신호입니다. 질문이 페이지 코드(
MT.0020)를 언급하면, 그 페이지 자신의 도움말 페이지가 맨 위에 고정됩니다. 임베딩은 코드를 뭉개지만, 필터는 그렇지 않습니다. - 매뉴얼이 릴리스 노트를 이깁니다, 질문이 버전이나 릴리스를 묻는 경우가 아니라면. 릴리스 노트는 모든 걸 언급하지만 아무것도 설명하지 않습니다.
- 페이지당 최대 두 개의 패시지, 긴 페이지 하나가 결과 목록 전체를 채우지 못하도록.
- 사전 확률로서의 인기도(테이블 조회 도구용): 다른 많은 테이블 설명이 언급하는 테이블이, 이름이 비슷한 잘 안 알려진 뷰보다 정답일 가능성이 높습니다. 이 하나의 사전 확률이 그 도구에서 가장 큰 개선을 줬습니다.
이것들은 각각 한두 줄의 스코어링 코드이고, 고정된 질문 세트(hit@k, MRR)에 맞춰 튜닝하고 변경할 때마다 다시 돌렸습니다. 그 세트가 없었다면 감으로 튜닝했을 겁니다.
5단계: 시작을 지루하게 만들기
9,000개 패시지를 임베딩하는 데 노트북 CPU로 약 22분이 걸리므로, 컨테이너는 시작할 때 절대 이 일을 하면 안 됩니다. 파이프라인을 세 단계로 나눴습니다.
| 단계 | 시점 | 비용 |
|---|---|---|
snapshot: 코퍼스 → 행과 float16 벡터가 담긴 parquet | 문서가 바뀔 때; 결과물을 커밋함 | 노트북에서 전체 실행 약 25분, 코어가 많은 머신에서는 몇 분; 바뀌지 않은 패시지는 벡터를 재사용함(모델 이름과 텍스트의 해시로 키를 잡음) |
build: parquet → Lance 테이블과 전문 검색 인덱스 | docker build | 3초 |
serve: 테이블 열기, 모델 로드 | 컨테이너 시작 | 1~2초 |
두 코퍼스(문서와 테이블 설명)를 합치면 12MB짜리 parquet 스냅샷이 됩니다. 모델은 이미지에 구워 넣고, 컨테이너는 HF_HUB_OFFLINE=1로 돌면서 네트워킹을 끈 채로 4초 안에 준비됩니다. 유휴 메모리는 약 200MB입니다.
전에는 할 수 없었던 비교
클라우드 인덱스가 돌아왔을 때, 저희는 에이전트 평가 세트에서 가져온 15개의 문서 질문으로 두 시스템을 똑같이 돌려봤습니다. 각 질문에는 정답이 인용해야 하는 페이지들, 즉 정답 페이지 코드 집합이 있습니다. n번째 패시지가 그 페이지들 중 하나에 속하거나 그것을 가리키면, 순위 n에서 적중으로 셉니다. 두 인덱스 모두 같은 마크다운 지식 베이스에서 만들어졌습니다.
클라우드 쪽에서는 같은 인덱스에 대해 세 가지 모드를 시도했습니다: 키워드만, 하이브리드(키워드 + text-embedding-3-small 벡터, 1,536차원), 그리고 서비스의 시맨틱 리랭커를 더한 하이브리드. 각 질문은 두 번 물었습니다: 에이전트가 쓸 법한 짧은 검색 쿼리로, 그리고 사용자의 원문 질문으로.
에이전트 스타일 쿼리 (예: “equipment downtime registration screen”):
| 시스템 | hit@1 | hit@5 | MRR | p50 지연 시간 |
|---|---|---|---|---|
| 로컬: 하이브리드 + 리랭크 | 0.60 | 0.87 | 0.71 | 0.99초 |
| 로컬: 하이브리드, 리랭크 없음 | 0.60 | 0.80 | 0.70 | 0.03초 |
| 클라우드: 키워드 | 0.40 | 0.80 | 0.57 | 0.87초 |
| 클라우드: 하이브리드 | 0.67 | 1.00 | 0.81 | 1.10초 |
| 클라우드: 하이브리드 + 시맨틱 리랭크 | 0.53 | 0.80 | 0.67 | 1.18초 |
원문 질문 (예: “How is equipment downtime registered? Is it the same as a planned outage, and where do I record it?”):
| 시스템 | hit@1 | hit@5 | MRR | p50 지연 시간 |
|---|---|---|---|---|
| 로컬: 하이브리드 + 리랭크 | 0.47 | 0.87 | 0.64 | 1.11초 |
| 로컬: 하이브리드, 리랭크 없음 | 0.47 | 0.80 | 0.57 | 0.04초 |
| 클라우드: 키워드 | 0.27 | 0.67 | 0.47 | 0.92초 |
| 클라우드: 하이브리드 | 0.47 | 0.93 | 0.63 | 1.17초 |
| 클라우드: 하이브리드 + 시맨틱 리랭크 | 0.53 | 0.73 | 0.61 | 1.31초 |
이 수치를 읽는 방법:
- 클라우드 하이브리드가 깔끔한 쿼리에서는 최고입니다. 15건 전부에서 상위 5개 안에 정답 페이지를 찾아냈습니다. 짧고 키워드 중복이 적은 쿼리일수록 더 큰 임베딩 모델의 힘이 드러납니다.
- 원문 질문에서는 둘이 비슷합니다(MRR 0.64 대 0.63). 길고 수다스러운 질문은 리랭커가 필요합니다. 리랭커 없이는 로컬 MRR이 0.57까지 떨어집니다.
- 키워드만 쓰는 검색은 양쪽 모두에서 분명히 떨어집니다. “로컬 RAG"가 BM25뿐이라면, 15~25 MRR 포인트를 그냥 버리는 셈입니다.
- 클라우드의 시맨틱 리랭커는 이 세트에서 도움이 되지 않았습니다. 일부 정답 페이지를 1위로 올렸지만, 다른 것들은 상위 5위 밖으로 밀어냈습니다. 비용을 치르기 전에 측정하세요.
- 15개는 작은 샘플입니다. 질문 하나가 hit@k를 0.067 움직입니다. 0.1 미만의 차이는 잡음으로 취급하세요. 전체 69개 문서 질문 세트에서 로컬 엔진은 hit@5 0.83, MRR 0.64로, 위 수치와 일치합니다.
테이블 조회: 도메인 규칙이 결실을 보는 곳
두 번째 도구는 질문을 약 3,300개의 테이블 설명 중 하나에 매핑합니다. 클라우드 인덱스도 같은 설명들을 가지고 있습니다(3,298개 문서, text-embedding-3-small 벡터, 시맨틱 설정). 절차는 동일합니다: 평가 세트에서 가져온 15개 질문, 정답 = 올바른 답이 쓰는 테이블들.
| 시스템 | 에이전트 쿼리: hit@1 | hit@5 | MRR | 원문 질문: hit@1 | hit@5 | MRR |
|---|---|---|---|---|---|---|
| 로컬: 하이브리드 + 사전 확률 + 리랭크 | 0.53 | 0.87 | 0.67 | 0.67 | 0.80 | 0.72 |
| 클라우드: 키워드 | 0.27 | 0.33 | 0.33 | 0.13 | 0.40 | 0.26 |
| 클라우드: 하이브리드 | 0.27 | 0.53 | 0.40 | 0.27 | 0.73 | 0.49 |
| 클라우드: 하이브리드 + 시맨틱 리랭크 | 0.47 | 0.87 | 0.62 | 0.33 | 0.73 | 0.49 |
여기서는 그림이 뒤집힙니다. 테이블 이름은 밀도 높은 축약어이고, 많은 테이블이 단어 대부분을 공유합니다(“일별 현장 합계”, “월별 현장 합계”, 같은 것의 읽기 전용 일별 요약). 일반적인 관련성 판단으로는 이들을 구분할 수 없지만, 인기도 사전 확률, 시간 단위 신호(“일별”, “월별”), 이름 속 축약어 풀어주기는 구분할 수 있습니다. 클라우드의 시맨틱 리랭커는 이 인덱스에서는 제값을 합니다(에이전트 쿼리에서 MRR 0.40 → 0.62), 하지만 원문 질문에서는 여전히 크게 뒤처집니다.
두 도구 모두에 대한 정직한 주의사항 하나: 로컬 가중치는 이 15개 질문이 나온 바로 그 세트로 튜닝되었습니다. 이건 클라우드 인덱스에는 없는 인-샘플 이점입니다. 가장 큰 영향을 미치는 곳은 규칙이 가장 구체적인 테이블 조회입니다. 테이블 조회의 격차는 “로컬 엔진이 전반적으로 더 낫다"가 아니라 “도메인 규칙은 그만큼의 값어치가 있다"로 읽으세요.
속도는 얼마나 빠른가?
| 단계 | 중앙값 |
|---|---|
| 쿼리 임베딩(bge-small) | 13ms |
| BM25 + 벡터 검색, 각각 상위 100개 | 30~40ms |
| 크로스 인코더 리랭크, 20개 패시지 | ~1,000ms |
| 크로스 인코더 리랭크, 10개 패시지 | ~500ms |
검색 자체는 거의 공짜이고, 시간은 리랭커에서 다 소모됩니다. 20개 대신 10개 패시지를 리랭크하면, 에이전트 스타일 쿼리에서는 변화 없이(MRR 0.71 그대로) 비용이 절반으로 줄고, 원문 질문에서는 약간의 손실이 있습니다(0.64 → 0.61). 여러분의 에이전트가 좋은 검색 쿼리를 쓴다면(도구 설명에서 그렇게 요청할 수 있습니다), 리랭커를 끄고 약 40ms에 답할 수 있습니다.
클라우드 수치에는 유럽의 노트북에서 미국 리전까지의 왕복, 그리고 하이브리드 모드에서는 서비스 자신의 임베딩 모델 호출까지 포함되어 있습니다. 같은 리전이라면 더 낮을 겁니다. 로컬 수치에는 네트워크 홉이 전혀 없습니다.
장단점
| 로컬 | 클라우드 검색 서비스 |
|---|---|
| 계정도, 키도, 이그레스도 없음: 문서가 상자를 벗어나지 않음 | 매니지드: 스케일링, 가용성, 보안 검토를 누군가 대신 해줌 |
| 인덱스는 파일: 코드와 함께 버전 관리되고, 재현 가능하고, diff 가능함 | 인덱스는 서비스 안에 있음; 다시 만드는 건 커밋이 아니라 파이프라인임 |
| 모든 랭킹 규칙을 직접 바꾸고 테스트할 수 있음(테이블 조회: 원문 질문에서 MRR 0.72 대 0.49) | 랭킹 조절은 서비스가 노출하는 범위로 제한됨 |
| 리랭크 없이 30~40ms | 기본으로 더 큰 임베딩 모델을 쓸 수 있음 |
| 에어갭 환경과 고객 호스팅 설치에서도 돌아감 | 수백만 문서와 빈번한 업데이트를 처리함 |
| 튜닝, 모델 업데이트, 평가 세트를 직접 소유함 | 짧고 일반적인 쿼리에서 첫 시도 품질이 더 좋음(문서: MRR 0.81 대 0.71) |
| 모델과 런타임을 합쳐 ~2GB 이미지; CPU를 많이 쓰는 리랭커 | 검색 유닛당 매달 나가는 고정 요금, 임베딩 호출 비용 추가 |
직접 해본다면 예상할 수 있는 것
- 첫째 날: 위의 범용 파이프라인, 컨테이너 하나, 그리고 에이전트의 도구를 여기로 바꾸는 것. 에이전트가 다시 실제 페이지를 인용하게 됩니다.
- 둘째 날: 알려진 답을 가진 실제 질문 50~100개로 된 평가 세트, 그리고 4단계의 도메인 규칙들. 여기서 클라우드의 하이브리드 모드에 가까워집니다.
- 계속해서: 문서가 바뀌면
snapshot을 다시 돌리고, 가중치를 손댈 때마다 평가를 다시 돌리세요. 임베딩 모델을 바꾼다는 건 전부 다시 임베딩한다는 뜻이니, 하나를 골라서 유지하세요. - 적합하지 않은 경우: 분 단위로 바뀌는 코퍼스, 수백만 문서, 또는 여러 언어(bge-small은 영어 모델입니다. 다국어 모델도 있지만, 먼저 평가해보세요).
한계
- 임베딩 크기는 짧은 쿼리에서 중요합니다. 384차원 CPU 모델은 저렴하고 좋지만, 짧고 중복이 적은 쿼리에서는 1,536차원 API 모델만 못합니다. 도메인 규칙과 리랭커가 그 격차의 대부분을 좁혀주지만, 완전히 없애지는 못합니다.
- 크로스 인코더는 CPU 세금입니다. 20개 패시지에 약 1초가 걸립니다. 이를 감안해 컨테이너 크기를 잡거나, 긴 질문에만 쓰도록 제한하세요.
- 평가 세트가 곧 제품입니다. 이 글의 모든 수치는 누군가 직접 작성하고 채점한 질문 세트에서 나왔습니다. 그게 없으면 어떤 변경이 도움이 됐는지 알 수 없고, 무엇과도 비교할 수 없습니다.
- 인-샘플로 튜닝됨. 저희 가중치는 비교에 쓴 것과 같은 질문 세트에서 나왔습니다. 공정한 재대결에는 튜닝 이후에 작성한 홀드아웃 세트가 필요합니다.
마치며
클라우드 검색 인덱스는 편리하지만, 대체 불가능한 건 아닙니다. 문서 몇천 개 규모의 코퍼스라면, BM25와 벡터를 쓰는 임베디드 엔진, 작은 CPU 임베딩 모델, 그리고 reciprocal rank fusion만으로 하루 안에 실제로 쓸 수 있는 대체재를 만들 수 있습니다. 몇 가지 도메인 규칙과 리랭커를 더하면, 문서 질문에서는 클라우드의 하이브리드 모드와 오차 범위 안에서 비슷해지고, 깔끔하고 짧은 쿼리에서는 한 걸음 뒤지지만, 도메인 규칙이 일을 하는 테이블 조회에서는 훨씬 앞섭니다. 그 대가로, 인덱스는 저장소 안의 파일이 되고, 랭킹은 테스트할 수 있는 코드가 되며, 아무것도 기기 밖으로 나가지 않습니다. 파이프라인은 쉬운 부분입니다. 다음에 제일 먼저 만들 것은 질문 세트일 겁니다.