Каждый чат с агентом начинается с нуля. В понедельник кто-то вместе с ассистентом разбирает показатели по двум площадкам, записывает, кто за какое последующее действие отвечает, и утверждает бюджетный сценарий. В четверг он открывает новый чат и спрашивает «что мы решили по N-11?» — а агент понятия не имеет, что такое N-11. Пользователь прокручивает назад, копирует, вставляет и объясняет всё заново.
Эта статья показывает, как мы закрыли этот разрыв совсем небольшим количеством кода. Агенту даётся один инструмент, recall_my_conversations, который ищет по более ранним чатам текущего пользователя и возвращает датированные фрагменты. Поисковый движок — funes, open-source проект, который мы переиспользовали вместо того, чтобы писать свой. Связующим звеном служит небольшой сервер FastMCP, и всё это работает в одном контейнере.
Это третья часть серии об инструментах для агентов через MCP. Первая дала агенту безопасное место для выполнения Python. Вторая удержала большие объёмы данных вне истории диалога, передавая ссылки вместо строк. Эта позволяет агенту искать информацию в самих историях диалогов.
Вспоминание — это не память, и это нормально
«Память агента» обычно означает что-то амбициозное: систему, которая извлекает факты из диалогов, поддерживает профиль в актуальном состоянии, разрешает противоречия и незаметно подмешивает нужный контекст в каждый промпт. Это сложно построить и сложно доверять. Когда что-то идёт не так, агент «вспоминает» то, чего вы никогда не говорили, и никто не может понять, откуда это взялось.
Нам хотелось чего-то намного проще — что работает скорее как человек, ищущий что-то в собственной почте:
- Прошлое остаётся ровно таким, каким оно было. Ничего не резюмируется, не переписывается, не сливается.
- Агент сам решает, когда оглянуться назад, вызывая инструмент.
- В ответ приходят дословные фрагменты с датами, так что агент может их процитировать, а пользователь — проверить.
- Если ничего подходящего не нашлось, агент так и говорит.
Вспоминание даёт агенту подсказки из прошлого. Оно не даёт ему модель пользователя. Агент по-прежнему каждый раз рассуждает с нуля, но больше не работает с нуля. Он может подхватить параметры, которые использовал на прошлой неделе, записанного ответственного или принятое решение — вместо того, чтобы просить пользователя повторить их.
Оказывается, это даёт большую часть ценности при малой доле риска.
Не изобретайте велосипед заново: funes
Поиск по прошлым сессиям агента — для кодинг-агентов это давно решённая задача. funes от Hugging Face — это «долговечная, доступная для поиска память о ваших прошлых сессиях агента». Он индексирует истории диалогов Claude Code, Codex и подобных, чтобы агент мог вспомнить более раннюю работу. (Мы использовали его при подготовке этой статьи, чтобы найти собственные более ранние тексты.)
Что делает его подходящим не только для ноутбука разработчика, но и для продукта:
- Один бинарник, никаких сервисов. Единственный исполняемый файл на Rust со встроенным движком хранения (Lance). Не нужно поднимать ни сервер БД, ни векторный сервис, ни очередь.
- Внутри нет LLM. Поиск работает на двух маленьких локальных моделях: эмбеддере bge-small-en-v1.5 и опциональном кросс-энкодере bge-reranker-base. Ничего не покидает контейнер, и вспоминание не может галлюцинировать. Оно возвращает только реально существующий текст.
- Память — это директория.
FUNES_HOME=/some/dirдаёт независимую память. Одной директории на пользователя достаточно для всей изоляции арендаторов, которая нужна слою хранения. - Простой формат ввода. Индексируются файлы
.funes.jsonl: одна строка на сообщение с id сессии, порядковым номером, временной меткой, ролью и текстовыми блоками. Это может сгенерировать любая чат-система. - Команды чтения для агентов:
recall(ранжированный поиск),get(чтение диапазона сессии),scan(точная строка в одной сессии),sessions,sketch. - Лояльные лицензии: funes — Apache-2.0, обе модели — MIT.
Как вспоминание устроено внутри
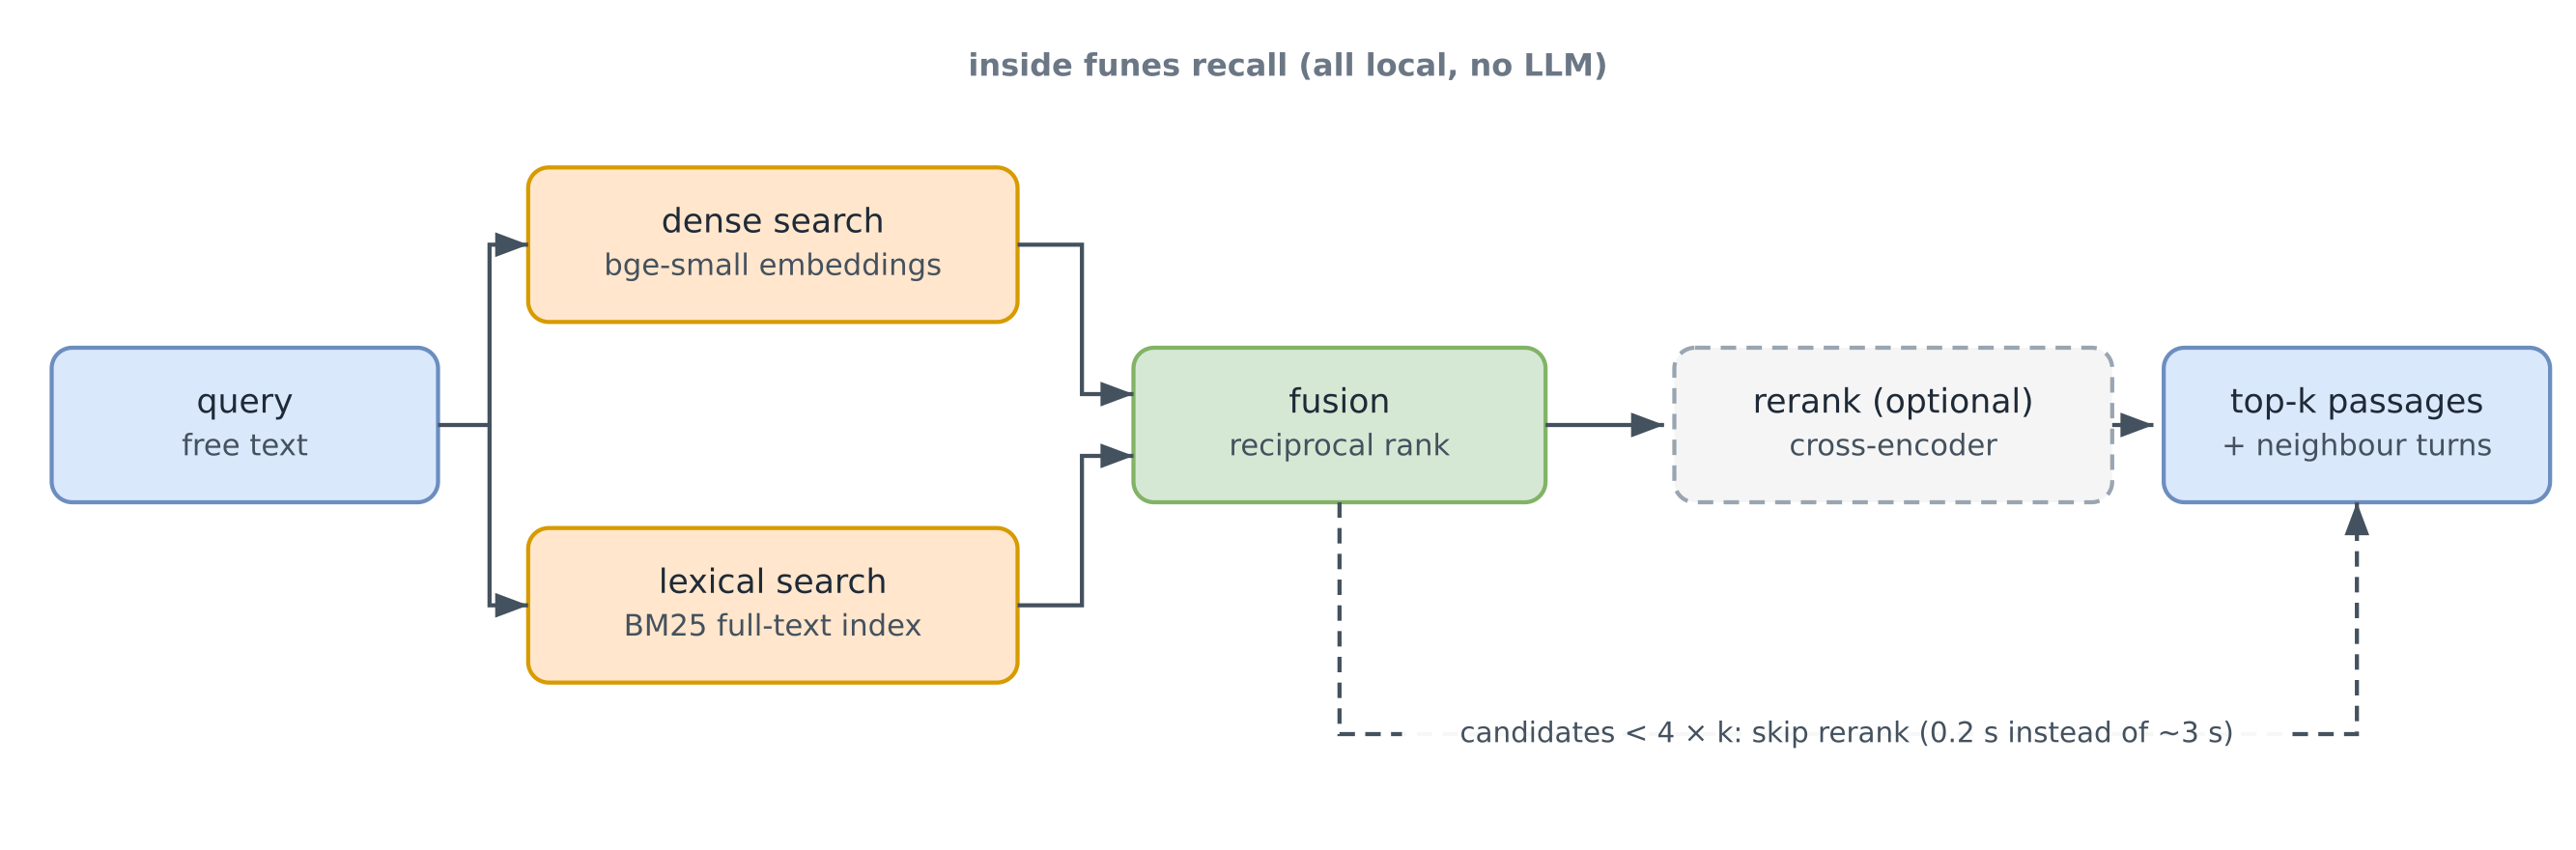
Запрос одновременно идёт по двум путям. Плотный векторный поиск находит фрагменты со схожим смыслом («наряд-заказ» находит «тикет»). Полнотекстовый поиск BM25 находит точные токены вроде MT-4471 или N-11, с которыми эмбеддинги справляются плохо. Два ранжированных списка объединяются через reciprocal rank fusion, и каждое совпадение возвращается вместе с соседними репликами, так что агент видит не только ответ, но и вопрос, который к нему привёл.
Такое же разделение мы наблюдали в нашем эксперименте с поиском имён таблиц. Плотный и лексический поиск проваливаются на разных запросах, и объединить их — дешёвая страховка. funes делает это из коробки.
Необязательный третий этап — кросс-энкодер, пересчитывающий оценки пула. funes включает его, когда пул кандидатов хотя бы в четыре раза больше k. Это стоит около трёх секунд и 1,6 ГБ RAM на вызов (цифры ниже). Для диалогового вспоминания мы держим его выключенным: пул остаётся меньше 4 × k, а агент компенсирует это, переспрашивая другими словами, когда первая попытка промахивается.
Архитектура
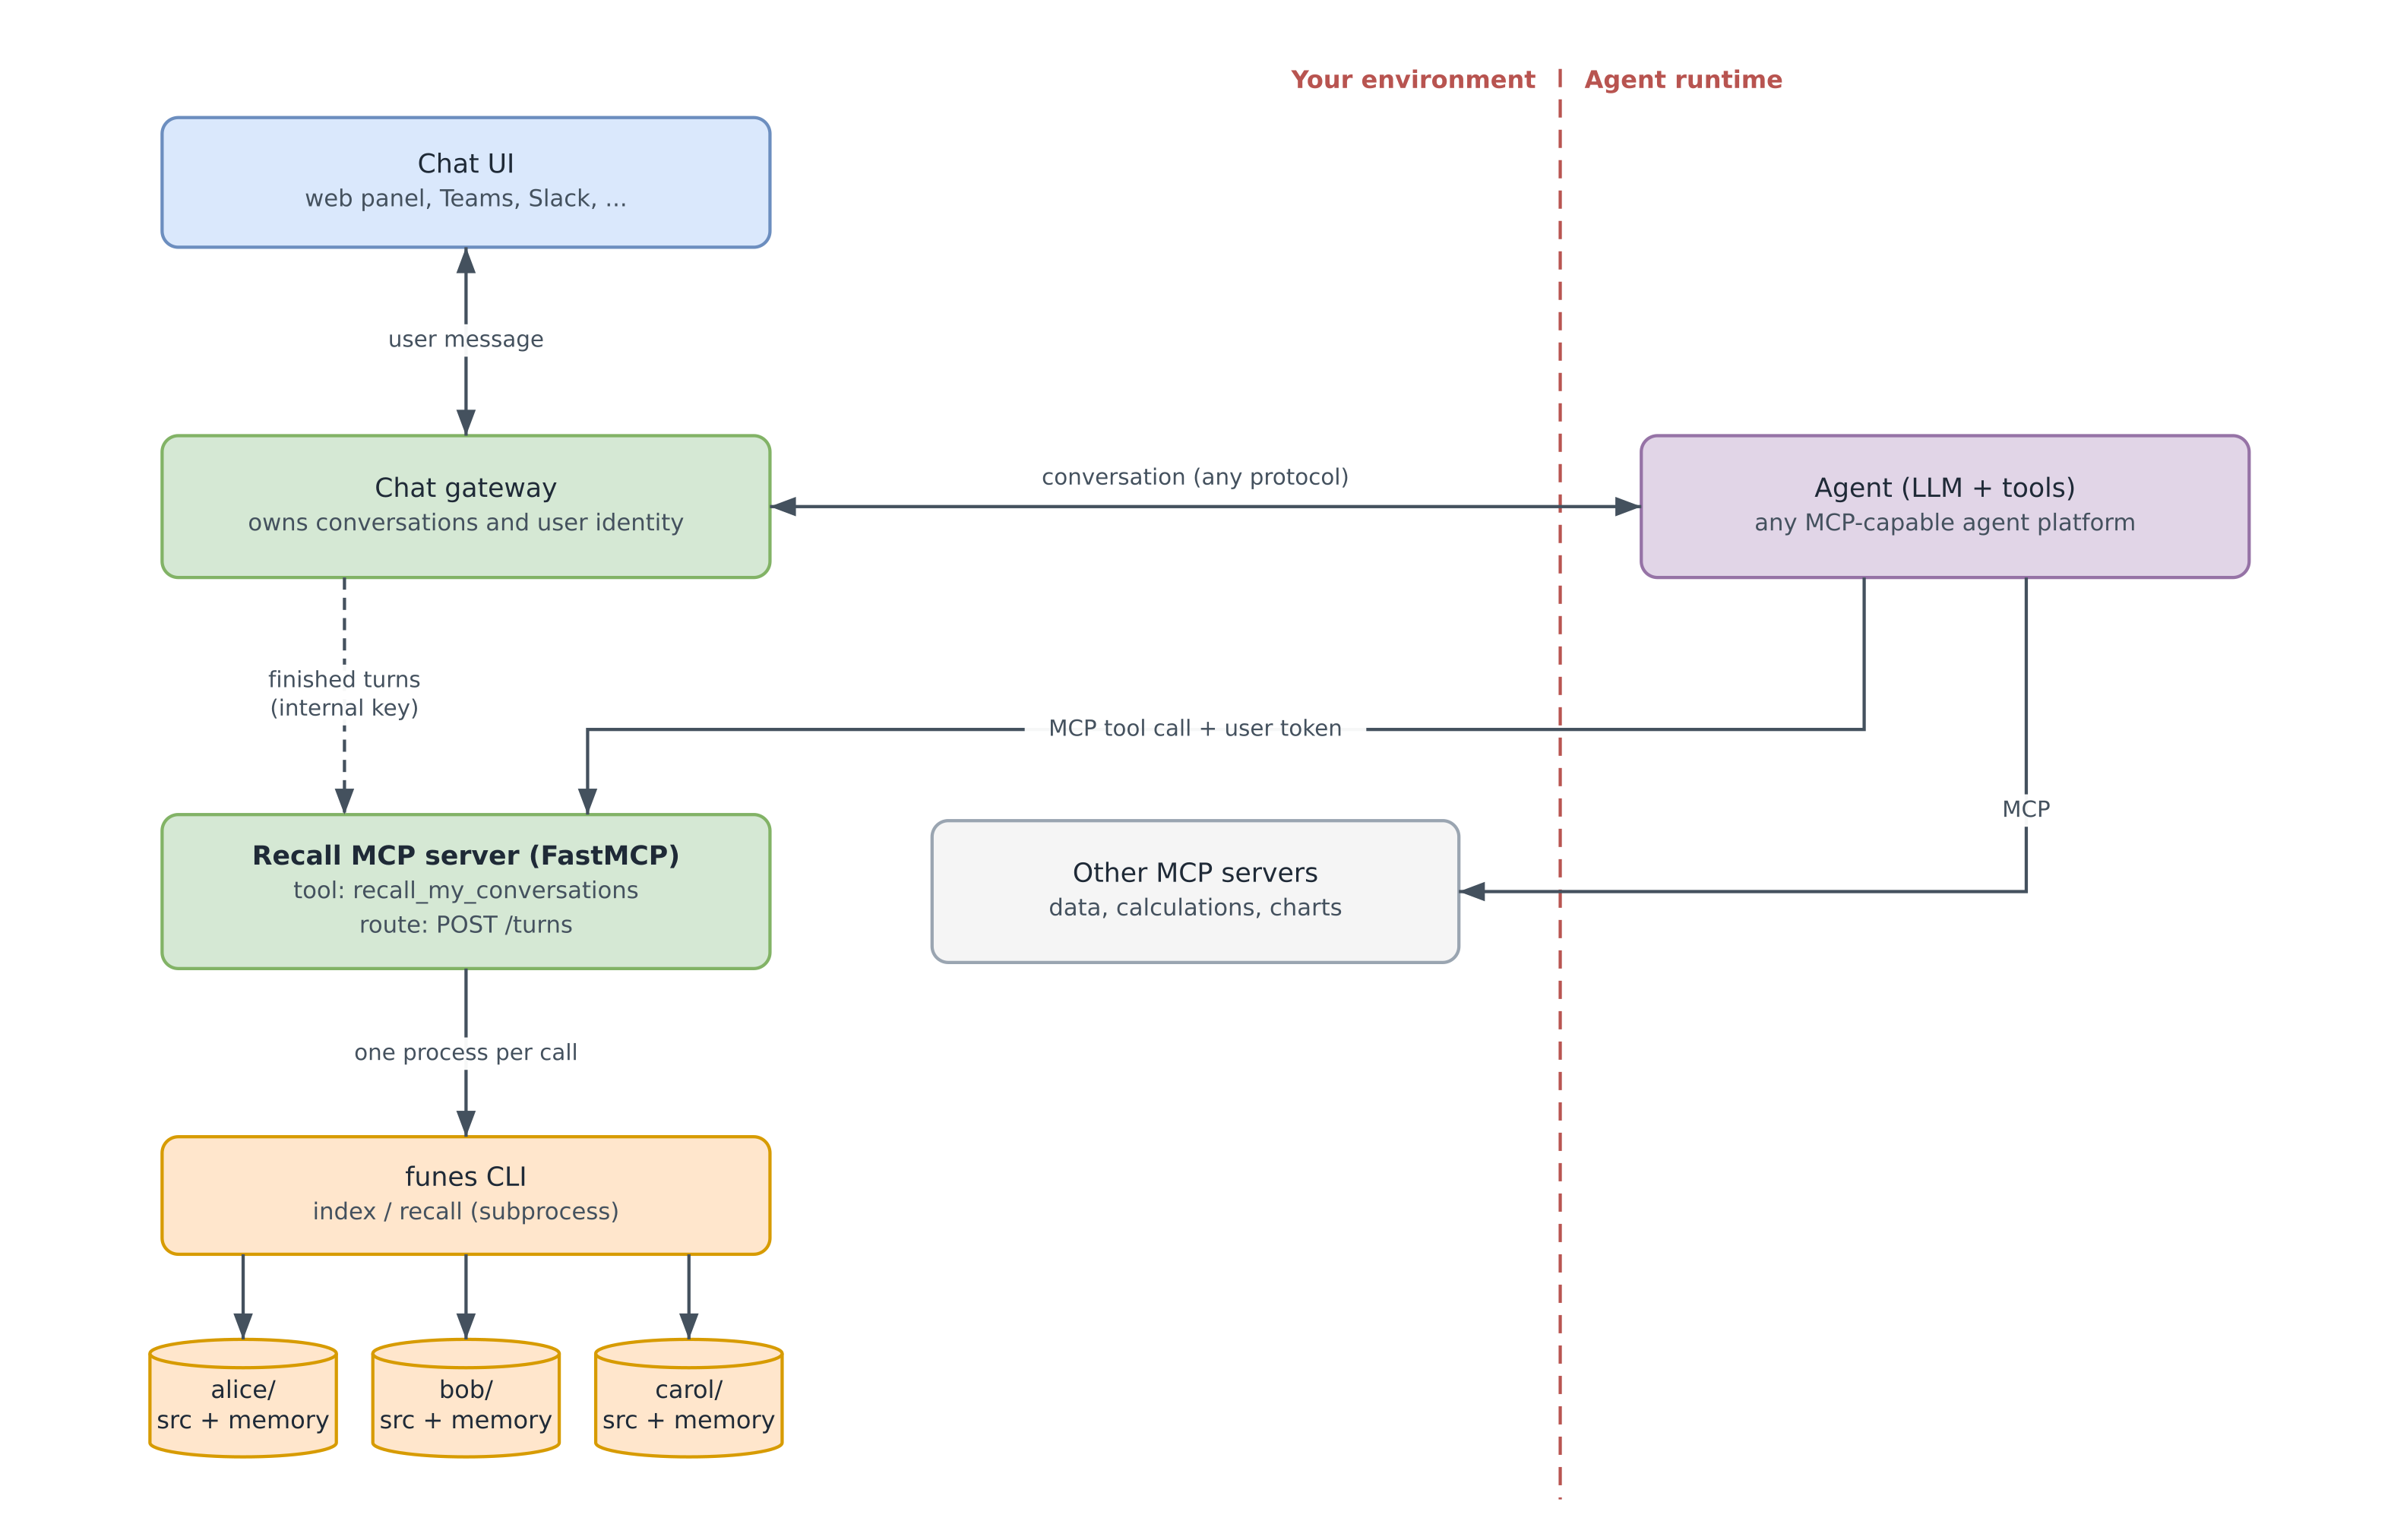
Есть два пути, и они намеренно используют разные учётные данные:
- Путь записи (пунктир). Чат-шлюз и так видит каждое сообщение, так что он пересылает каждую завершённую реплику на сервер вспоминания по внутреннему маршруту, защищённому общим ключом. Платформа агента в этом не участвует. Она не может писать в память, и prompt injection не может подложить «воспоминания».
- Путь чтения. Агент вызывает
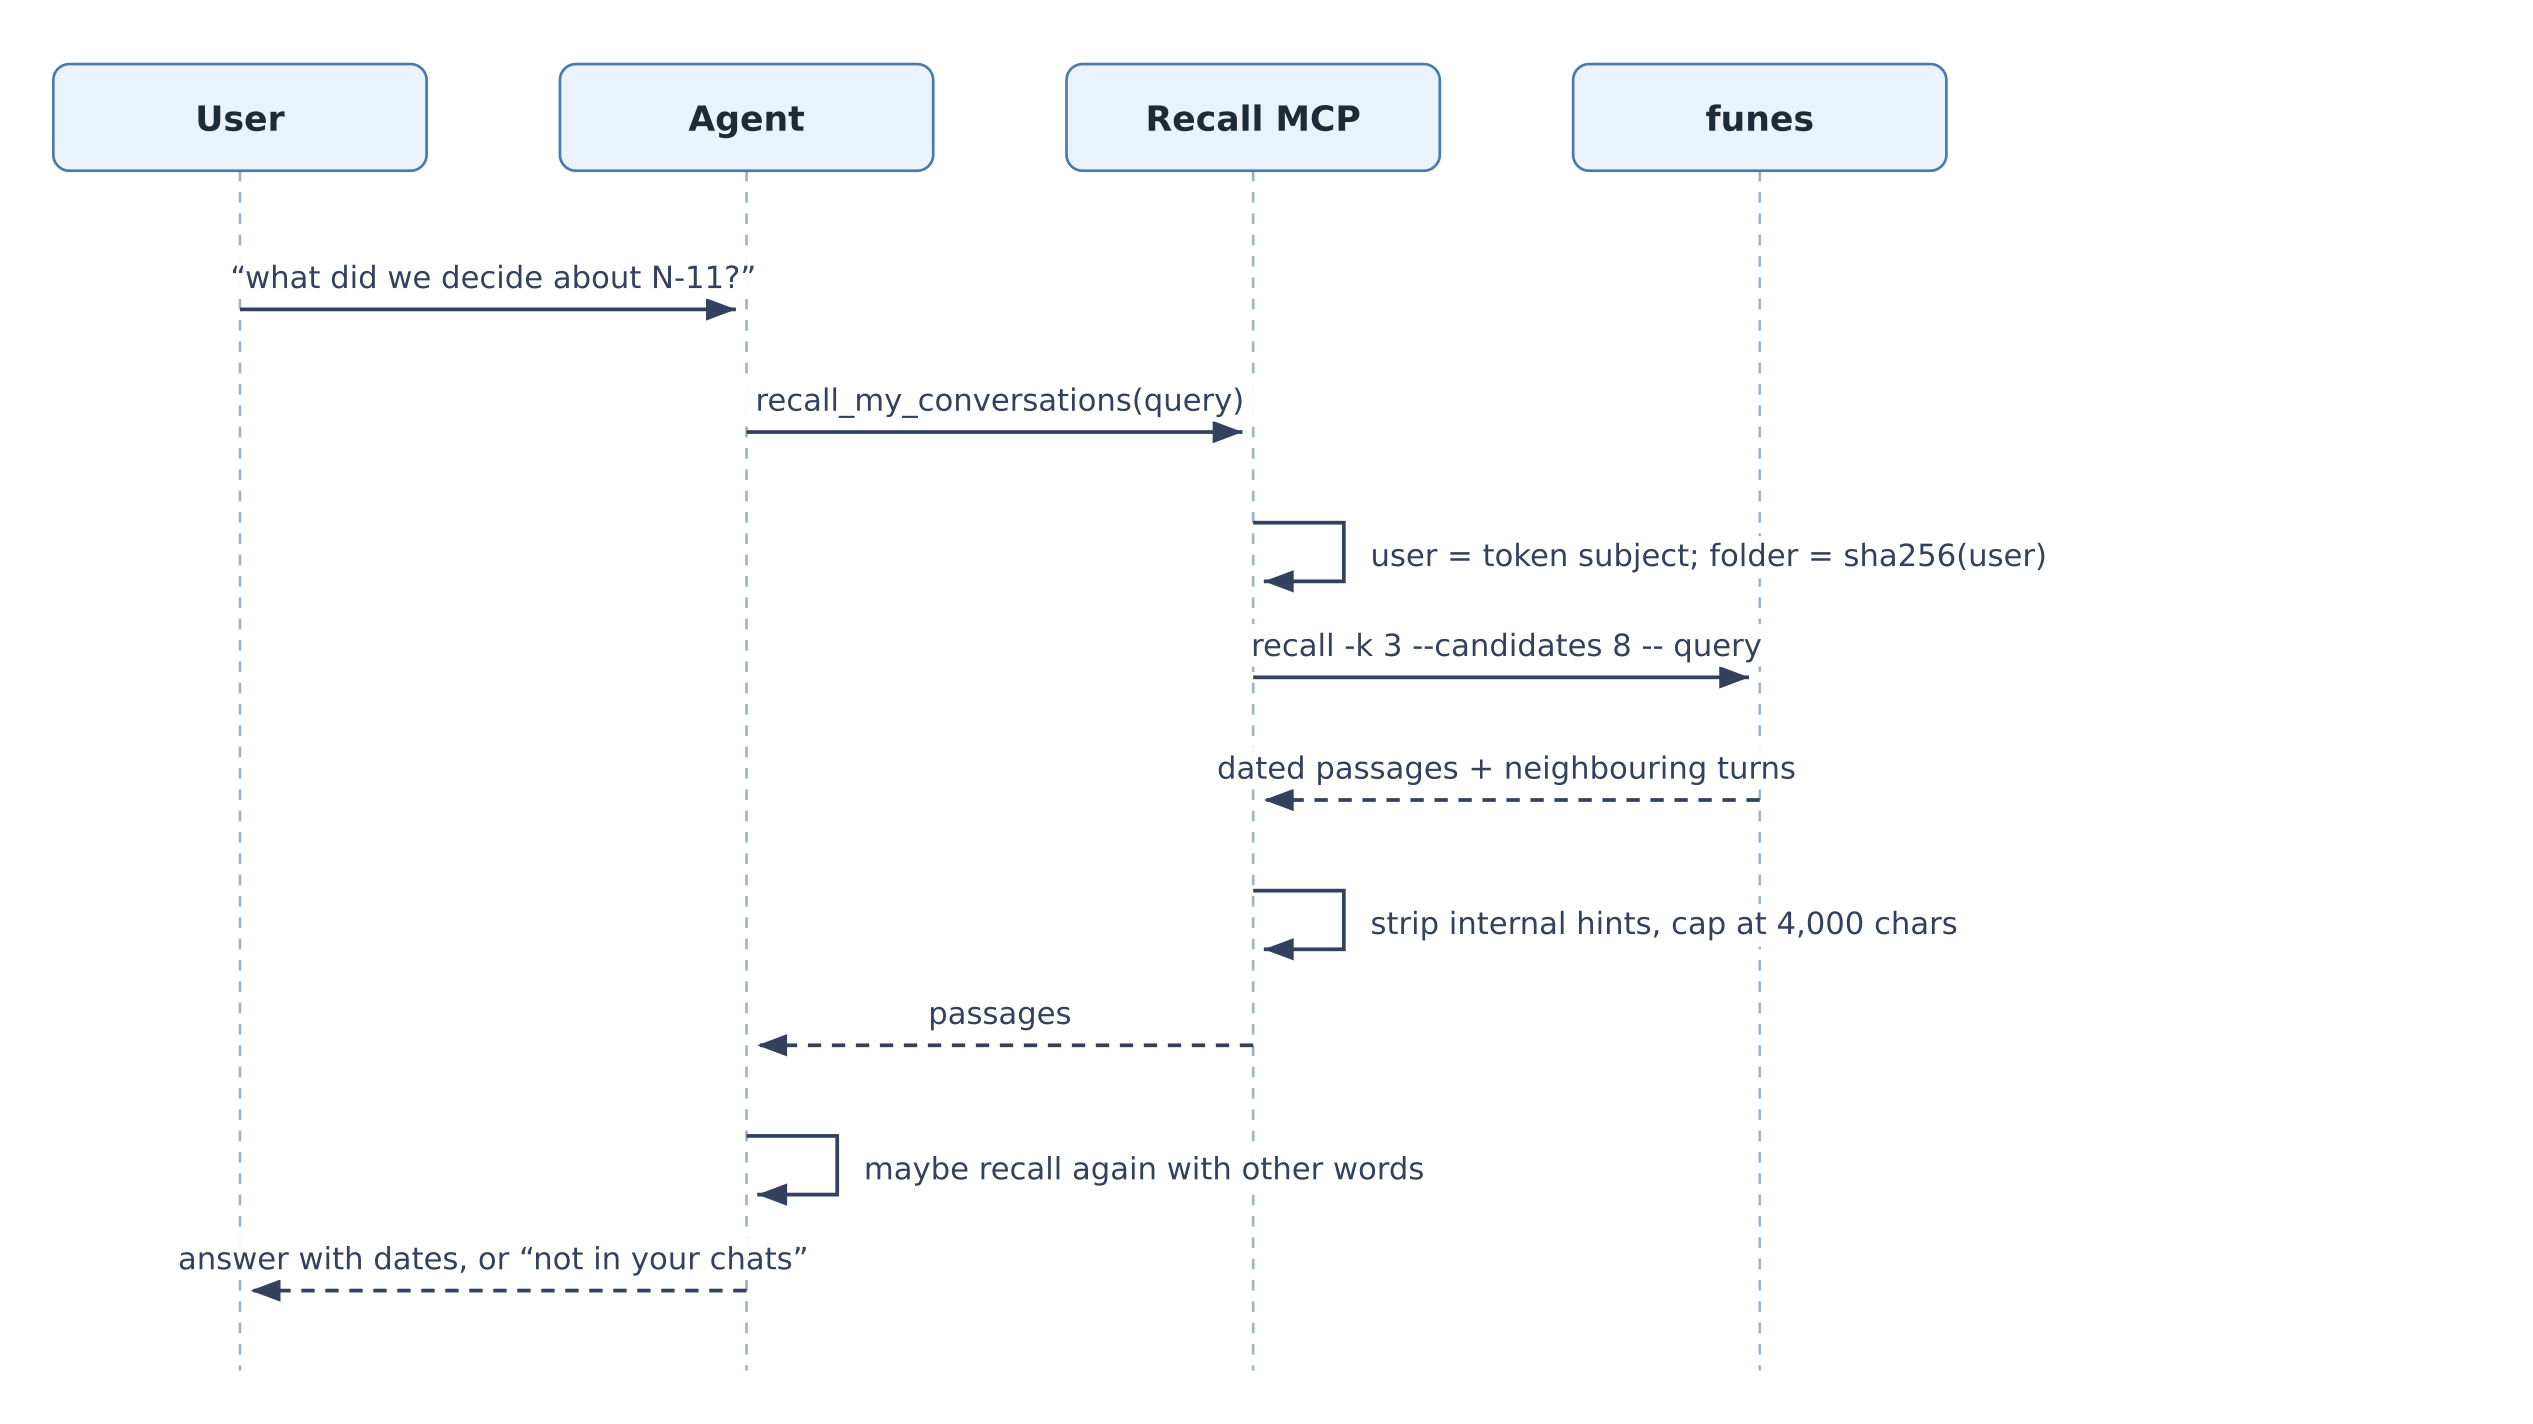
recall_my_conversationsтак же, как любой другой инструмент MCP. Сервер берёт пользователя из токена вызывающего и ищет только в директории этого пользователя. Текст запроса никогда не выбирает, чья память ищется.
Платформой агента может быть что угодно, что говорит на MCP. Мы впервые реализовали это внутри продакшен-копайлота, работающего на коммерческой платформе агентов, с MCP-сервером на Java. Демо ниже — самодостаточная версия того же дизайна на одном Python.
Путь записи: пересылка завершённых реплик
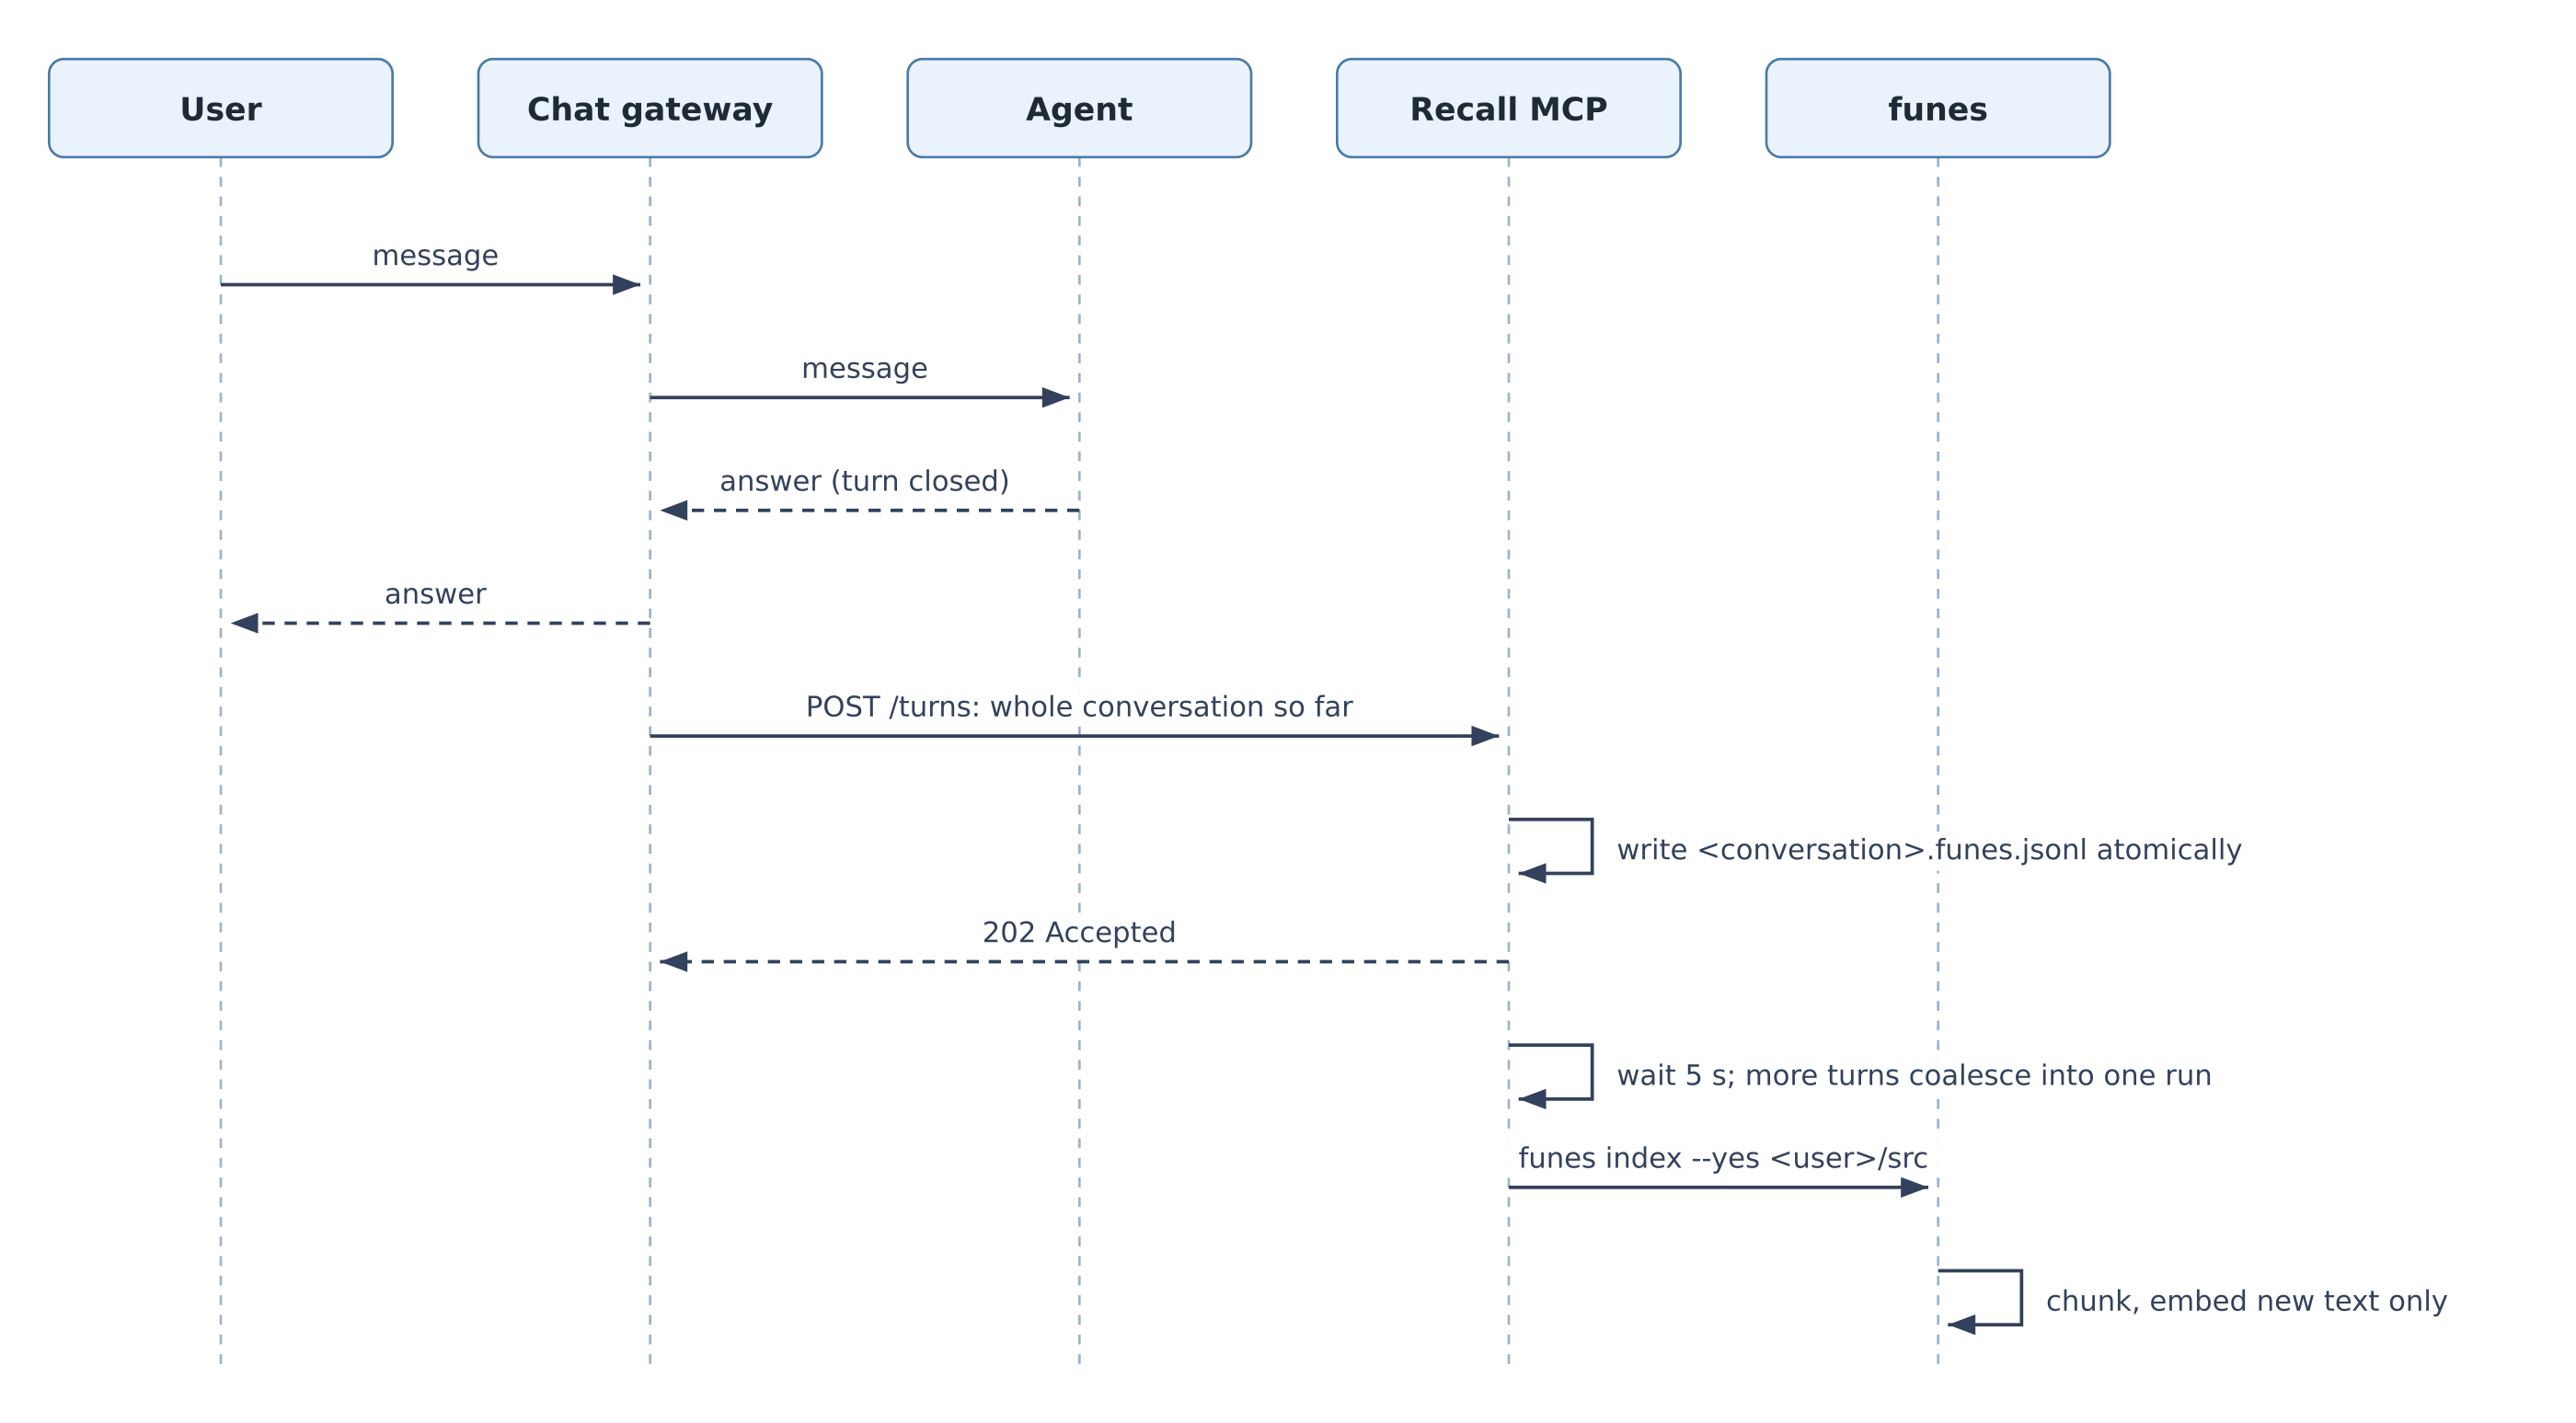
Шлюз после каждой реплики отправляет весь диалог целиком на данный момент. Звучит расточительно, но это делает запись идемпотентной: сервер атомарно перезаписывает один файл на диалог, а funes, который отслеживает, что уже заэмбеддено, обрабатывает только новый текст.
@mcp.custom_route("/turns", methods=["POST"])
async def ingest(request: Request) -> JSONResponse:
    if not hmac.compare_digest(request.headers.get("x-ingest-key", ""), INGEST_KEY):
        return JSONResponse({"error": "unauthorized"}, status_code=401)
    body = await request.json()
    user, cid = body.get("user"), body.get("conversation_id", "")
    if not user or not re.fullmatch(r"[A-Za-z0-9_-]{1,128}", cid):
        return JSONResponse({"error": "user and a safe conversation_id are required"}, status_code=400)
    payload = to_funes_jsonl(cid, body.get("turns", []))

    src = home(user) / "src"
    src.mkdir(parents=True, exist_ok=True)
    tmp = src / f".{cid}.tmp"
    tmp.write_text(payload)
    tmp.replace(src / f"{cid}.funes.jsonl")   # atomic: recall never sees half a file
    schedule_index(user)
    return JSONResponse({"stored": cid}, status_code=202)
home(user) — это DATA / sha256(user)[:24], так что имена директорий не раскрывают id пользователей. Преобразование в формат funes занимает несколько строк:
def to_funes_jsonl(conversation_id: str, turns: list[dict]) -> str:
    lines = []
    for seq, t in enumerate(turns):
        ts = datetime.fromisoformat(t["ts"].replace("Z", "+00:00")).astimezone(timezone.utc)
        lines.append(json.dumps({
            "session_id": conversation_id, "turn_uuid": t.get("id") or f"{conversation_id}-{seq}",
            "seq": seq, "ts": ts.strftime("%Y-%m-%dT%H:%M:%SZ"), "role": t["role"],
            "harness": "copilot", "blocks": [{"block_type": "text", "text": t["text"]}],
        }))
    return "\n".join(lines) + "\n"
Индексация дебаунсится по каждому пользователю отдельно. Пачка реплик порождает один запуск funes index, никогда два одновременных запуска для одной директории, а запись, пришедшая во время выполнения, гарантирует ровно ещё один дополнительный запуск:
def schedule_index(user: str) -> None:
    st = index_state.setdefault(user, {"task": None, "dirty": False})
    st["dirty"] = True
    if st["task"] is None or st["task"].done():
        st["task"] = asyncio.create_task(index_loop(user))

async def index_loop(user: str) -> None:
    st = index_state[user]
    while st["dirty"]:
        await asyncio.sleep(INDEX_DEBOUNCE)
        st["dirty"] = False
        await funes(user, "index", "--yes", str(home(user) / "src"), timeout=300)
Вспоминание не ждёт индексации. Реплика становится доступной для поиска через несколько секунд после завершения, и это нормально, потому что никто не спрашивает «что мы только что сказали?» через поисковый инструмент.
Путь чтения: один инструмент
@mcp.tool
async def recall_my_conversations(query: str) -> str:
    """Search the current user's own earlier conversations with this assistant.
    Use it when the user refers to something discussed before ("last time", "earlier",
    "what did we decide", "the numbers we used"). Use short queries built around identifiers
    and key nouns ("K-2 machine ticket"); search again with other words if needed.
    Returns dated passages from past chats. Quote them; do not invent details."""
    user = get_access_token().client_id          # from the verified token, never from the query
    if not (home(user) / "memory").exists():
        return "No earlier conversations are stored for this user yet."
    async with recall_slots:
        code, out = await funes(user, "recall", "-k", str(RECALL_K),
                                "--candidates", str(RECALL_CANDIDATES), "--", query[:500],
                                timeout=RECALL_TIMEOUT)
    if code != 0:
        return "Conversation memory is unavailable right now; continue without it."
    out = HINT_LINE.sub("", out).strip()         # drop funes' "→ get <session> --memory <path>" hints
    return out[:MAX_RESULT_CHARS] or "Nothing relevant found in earlier conversations."
Несколько деталей важнее, чем кажется на первый взгляд:
- docstring — это и триггер, и инструкция. Агенты вызывают инструмент, когда его описание совпадает с формулировкой пользователя. «В прошлый раз», «раньше» и «что мы решили» — слова, которые люди реально используют. Описание также говорит, как формулировать запрос, потому что короткие запросы, насыщенные идентификаторами, ранжируются лучше (см. измерения).
--перед запросом. Пользователь, напечатавший-k 100, ищет именно этот текст, а не передаёт флаг.- Убирайте строки с подсказками. funes печатает
→ get <session> --memory <path>после каждого совпадения для агентов, умеющих вызыватьget. Наш не умеет, так что эти строки лишь протекают в ответ путями сервера и id сессий. Именно это мы увидели в первом же прогоне, когда агент начал цитировать префиксы id диалогов. - Мягкий отказ. Проблема с памятью никогда не должна ломать диалог. Инструмент сообщает, что память недоступна, и агент продолжает работу.
- Ограниченная стоимость. Не более четырёх одновременных вспоминаний, таймаут 10 секунд и лимит в 4000 символов на то, что попадает в контекст.
Сам вызов funes выполняется с очищенным окружением: FUNES_HOME указывает на директорию пользователя, выставлен HF_HUB_OFFLINE=1, а модели читаются из директории, запечённой в образ.
Упаковка: один контейнер
FROM python:3.12-slim

ARG FUNES_VERSION=1.8.0
ARG FUNES_SHA256=3c7eacbaa4487d253f8e13ef7223325ba05069fc258533db6e19bb5765181fea
ADD --checksum=sha256:${FUNES_SHA256} --chmod=0755 \
    https://github.com/huggingface/funes/releases/download/v${FUNES_VERSION}/funes-x86_64-linux /usr/local/bin/funes

# Bake the embedder: a throwaway index + recall downloads exactly what funes needs.
ARG BAKE_RERANKER=0
ENV HF_HOME=/opt/hf
RUN mkdir -p /tmp/warm/src \
 && echo '{"session_id":"warm","turn_uuid":"t0","seq":0,"ts":"2026-01-01T00:00:00Z","role":"user","harness":"copilot","blocks":[{"block_type":"text","text":"warm up"}]}' > /tmp/warm/src/w.funes.jsonl \
 && FUNES_HOME=/tmp/warm/home funes index --yes /tmp/warm/src \
 && FUNES_HOME=/tmp/warm/home funes recall -k 1 --candidates 2 warm \
 && if [ "$BAKE_RERANKER" = 1 ]; then FUNES_HOME=/tmp/warm/home funes recall -k 1 --candidates 8 warm; fi \
 && rm -rf /tmp/warm && chmod -R a+rX /opt/hf

RUN pip install --no-cache-dir fastmcp==4.1.0
WORKDIR /app
COPY recall_server.py .
RUN useradd -u 10001 -m app && mkdir -p /data/memories && chown app /data/memories
USER app
ENV HF_HUB_OFFLINE=1
CMD ["python", "recall_server.py"]
services:
  recall-mcp:
    build: .
    ports: ["8000:8000"]
    environment:
      INGEST_KEY: ${INGEST_KEY:-demo-ingest-key}
      RECALL_K: "3"
      RECALL_CANDIDATES: "8"
    volumes:
      - memories:/data/memories
volumes:
  memories:
Трюк, который стоит перенять, — шаг прогрева. Вместо того чтобы жёстко прописывать файлы моделей, сборка запускает одну маленькую индексацию и одно вспоминание, так что funes скачивает в HF_HOME ровно те модели, которые использует. В рантайме контейнер никогда не обращается к Hugging Face Hub. Слои образа: 218 МБ на бинарник funes, 134 МБ на эмбеддер и 119 МБ на FastMCP. Запекание реранкера добавило бы ещё 1,13 ГБ, и это ещё одна причина держать его выключенным. Используйте ADD --chmod, а не отдельный RUN chmod, который копирует 218-мегабайтный бинарник во второй слой.
Работает ли это? Две недели из жизни руководителя эксплуатации
Мы засеяли память шестью диалогами, какие могли бы реально случиться за две недели у человека, управляющего несколькими площадками: разбор показателей по двум площадкам, расчёты прогноза для бюджета, проверка состояния ночных заданий, передача смены, арифметика с коэффициентами и проверка мощностей. Эти примеры вымышленные и намеренно обобщённые; для вспоминания любая предметная область с ID, ответственными, тикетами и цифрами выглядит одинаково. Второй пользователь, bob, получил один диалог про другую площадку. Сидер играет роль чат-шлюза и отправляет диалог после каждой реплики, в точности как в продакшене.
В качестве агента мы использовали Claude в headless-режиме, с этим сервером как единственным инструментом и без какого-либо иного знания предметной области:
claude -p "$QUESTION" --strict-mcp-config --mcp-config mcp-alice.json \
  --tools "" --allowedTools mcp__recall__recall_my_conversations \
  --system-prompt "$(cat system.md)"
Каждый ответ ниже агент составил исключительно по вспомненным фрагментам.
Решение и его блокер, в двух чатах. «Что мы решили по апгрейду N-11, и что должно произойти до того, как его можно будет запланировать? Этот блокер всё ещё открыт, судя по моим заметкам?» Агент сделал четыре вспоминания (N-11 upgrade, N-11 blocker schedule, MT-4471 K-2 machine, K-2 closed) и ответил:
Решение (2026-10-08): вы решили продолжить с предложением по апгрейду N-11. Вы сказали, что нагрузка 91% «приемлема, но впритык». Ожидаемая нагрузка на линию North после апгрейда — около 2185 из 2400 единиц/день (91%). Прежде чем это можно будет запланировать: сначала нужно закрыть тикет на обслуживание MT-4471 (проблема с машиной K-2). Блокер всё ещё открыт? В моих заметках не отмечено, что он закрыт. […] Я не нашёл ничего после 2026-10-08, что говорило бы о решении или закрытии MT-4471. […] Проверьте тикет в системе обслуживания, прежде чем планировать.
Решение пришло из чата 10-08, а детали тикета — из передачи смены от 10-03. Агент связал их вместе и честно указал, чего в заметках нет.
Причина, найденная в двух чатах. «Почему колонки сверки были пустыми в конце сентября, и кому я это эскалировал?» В одном чате пользователь заметил пустые колонки и планировал спросить Tomas. В более позднем чате два неудачных запуска заданий привели к фиду данных F-204. С помощью двух вспоминаний агент связал это: запуски падали из-за разрыва в фиде F-204, а проблема была передана Priya, руководителю направления интеграций. Он добавил, что в чате зафиксирован только план эскалировать, и что два неудачных запуска (09-26 и позже) не объясняют пустые дни с 09-23 по 09-25. Он также сказал, что вспомненный текст обрезал точный текст ошибки. Это правда: funes возвращает соседние реплики как короткие превью, и агент честно сказал об этом, вместо того чтобы домысливать пробел.
Список задач из разных чатов. «Дай мне один сводный список моих открытых задач по всем прошлым чатам.» Пять вспоминаний дали семь пунктов из пяти разных чатов, у каждого — ответственный, срок и дата источника. Агент отметил просроченные относительно сегодняшней даты, указал, что два пункта на самом деле одна и та же проблема, и пометил место, где день недели был превращён в дату («в чате сказано только „четверг“»), чтобы пользователь мог проверить.
Точные цифры. «Какой прогнозный сценарий мы выбрали как базовый, с какими параметрами, и что он дал на 18 месяцев?» Гиперболический, q0 1500 единиц/день, Di 0,25/год, b 0,6, что даёт 1069,5 единиц/день и 693,3 тыс. единиц, с экспоненциальным сценарием для сравнения. Цифры точно совпадают с исходным расчётом, и агент добавил, что в чатах зафиксировано решение, но не причина, по которой оно было принято.
Негативный контроль и изоляция. «Я вообще когда-нибудь обсуждал мотор P-7 или тикет MT-5120?» От имени alice: «Нет. В прошлых чатах, которые я могу искать, нет ничего про мотор P-7 или тикет MT-5120». Он перечислил ближайшие совпадения (машина K-2, тикет MT-4471) как возможную путаницу. От имени bob тот же вопрос вернул его чат про узел South с шумом подшипника P-7 и тикетом MT-5120. alice не может увидеть историю bob, даже если слова совпадают точно, потому что её токен открывает только её собственную директорию.
Запуски агента занимали от 4 до 11 секунд целиком, с двумя-пятью вызовами вспоминания каждый. На сами вспоминания уходит около секунды из этого времени. Полные ответы — в examples/agent-runs.md.
Тот же результат на стеке, близком к продакшену
Прежде чем писать демо, мы подключили тот же дизайн к настоящему копайлоту: коммерческая платформа агентов, собственный чат-шлюз, MCP-сервер на Java и funes в том же контейнере. За четырьмя рабочими чатами (поиск данных, расчёты, заметка о передаче смены) последовали четыре чата со вспоминанием в новых диалогах. Агент сделал 13 вызовов вспоминания. Каждый вспомненный факт оказался верным, включая пересчёт бюджетного сценария на более длинный горизонт по вспомненным параметрам и негативный контроль по оборудованию, которое никогда не упоминалось. Одна вспомненная деталь пришла из ответа, чей стрим наш тестовый драйвер уже забросил. Шлюз всё равно переслал завершённую реплику, и память знала больше, чем тестовый харнесс.
Измерения
Чтобы выйти за рамки отобранных вручную примеров, мы сгенерировали синтетическую историю для одного пользователя: N диалогов по шесть сообщений, в каждом среди болтовни спрятан один проверяемый факт (номер тикета, процент брака контроля качества, ответственный за задачу или ссылка на решение). Дистракторы заложены намеренно. Каждая площадка и единица оборудования встречается примерно в шести диалогах (в болтовне и в составе других фактов), и одни и те же двенадцать человек, типы задач и симптомов повторяются повсюду, так что запрос должен совпасть с комбинацией и не может полагаться на одно редкое слово. У каждого вопроса ровно один верный ответ. Вопросы перефразированы: факт гласит «тикет MT-1040 открыт», а вопрос спрашивает «какой номер наряд-заказа был заведён на утечку сальника на насосе P-003?». Совпадение означает, что ожидаемый ответ встречается в тексте, который вернул инструмент.
Всё выполнялось внутри контейнера, ограниченного 4 CPU и 4 ГБ, с одним новым процессом funes на вызов — в точности как это делает сервер.
| 1000 диалогов | 3000 диалогов | 10 000 диалогов | |
|---|---|---|---|
| Сообщений / сырой текст | 6000 / 1,5 МБ | 18 000 / 4,5 МБ | 60 000 / 14,9 МБ |
| Вспоминание, k=3, пул 8 (наша настройка): доля попаданий | 91% / 93% | 93% / 95% | 100% / 97% |
| То же, короткие запросы в стиле агента | 94% | 95% | 98% |
| Вспоминание, k=8, пул 8: доля попаданий | 100% | 100% | 100% |
| Вспоминание с реранком, k=3, пул 32: доля попаданий | 99% | 99% | 100% |
| Задержка вспоминания p50 / p95 (без реранка) | 0,15–0,20 / 0,22 с | 0,16–0,19 / 0,23 с | 0,18–0,19 / 0,24 с |
| Задержка вспоминания p50 (с реранком) | 3,1 с | 3,0 с | 3,1 с |
| Пиковая память на вспоминание | 231 МБ (с реранком 1,64 ГБ) | 234 МБ (1,65 ГБ) | 240 МБ (1,66 ГБ) |
| Добавить один диалог (инкрементальная индексация) | 1,2–1,8 с, 270 МБ | 8–9 с, 305 МБ | 4,5–4,8 с, 390–400 МБ |
| Индексация с нуля (полная заливка) | 68–70 с, 650 МБ | 242 с, 1,26 ГБ | 19,5 мин, 1,9 ГБ |
| Директория памяти на диске | 86 МБ | 605 МБ | 424 МБ |
По 100 вопросов на каждый размер, 4 CPU. Там, где в ячейке два значения, бенчмарк запускался дважды с полной переиндексацией каждый раз; разброс — это вариация между прогонами сборки индекса.
Что говорят цифры:
- Задержка вспоминания не зависит от размера истории. Одно вспоминание стоит около 0,2 секунды и 240 МБ что при 1000, что при 10 000 диалогов, и большая часть этого — запуск процесса и загрузка эмбеддера. Для масштаба: инженер с десятью чатами в день накапливает около 2500 диалогов за год.
- Вопрос никогда не теряется, он просто оказывается ниже отсечки. С восемью фрагментами вместо трёх каждый вопрос давал совпадение при любом размере. С тремя — до 9% вопросов промахивались. У изученных нами промахов была одна общая причина: почти идентичные факты про другое оборудование («вибросигнализация срабатывает снова и снова» для K-039, K-019 и K-007) обгоняли правильный вариант, потому что длинный, перефразированный вопрос совпадал с ними по смыслу, а различающим был только ID. Тот же вопрос, сокращённый до «компрессор K-047 тикет», ставил правильный диалог на первое место. Именно так агенты и формулируют вызовы инструментов в принципе (запросы нашего агента выглядели как
MT-4471 K-2 compressor closed), и короткие запросы в целом получали чуть более высокие оценки. Мы добавили в описание инструмента фразу «используйте короткие запросы, построенные вокруг идентификаторов». - Реранкер отыгрывает промахи k=3, но по высокой цене. Он дотягивает до 99–100% при k=3, но это стоит в 15 раз больше по задержке, в 7 раз больше по памяти и добавляет в образ модель на 1,1 ГБ. Возврат большего числа фрагментов даёт ту же точность без затрат на задержку, но тратит токены контекста. Мы держим k=3, потому что агенты переспрашивают, если первая попытка не отвечает на вопрос. Поднимите k (и лимит символов), если ваш агент так не делает.
- Индексация дёшева там, где это важно. Новый диалог становится доступным для поиска за секунды и несколько сотен мегабайт, вне пути обработки запроса. Построение истории из 10 000 диалогов с нуля занимает 20 минут и 2 ГБ. Это разовая полная заливка, так что запускайте её как batch-задачу, а не внутри сервера.
- Использование диска скромное, но не линейное. Директория памяти хранит векторы, полнотекстовый индекс и версии таблиц. Её размер зависит от того, как часто движок хранения выполнял компакцию, поэтому в наших прогонах 3000 диалогов заняли больше места, чем 10 000. Закладывайте сотни мегабайт на очень активного пользователя и несколько мегабайт на типичного.
Что это такое, а что нет
| Это | А это нет |
|---|---|
| Поиск по собственным дословным прошлым чатам пользователя | База знаний или профиль пользователя |
| Инициировано агентом: агент сам решает, когда оглянуться назад | Контекст, незаметно подмешиваемый в каждый промпт |
| Датированные фрагменты, которые агент может процитировать, а пользователь проверить | Извлечённые «факты» без источника |
| Отдельно для каждого пользователя, изолировано токеном вызывающего | Общекомандное знание (это был бы отдельный, осознанный дизайн) |
| История только на дозапись | Нечто, знающее, что тикет закрыт, если только об этом не сказано в чате |
Ограничения
- История — не истина. Вспоминание возвращает то, что было сказано, включая ошибки и планы, которые так и не осуществились. Наш агент справлялся с этим хорошо («в ваших заметках не сказано, было ли это закрыто»), но это заслуга агента и его промпта. Сам инструмент этого гарантировать не может.
- Диалоги со вспоминанием тоже запоминаются. Ответы из диалогов со вспоминанием индексируются так же, как любая другая реплика. Обычно это помогает: сводный список задач тоже становится доступен для поиска. Но неверный ответ вспоминания тоже станет будущим «воспоминанием». Исключать реплики, состоящие в основном из вывода вспоминания, — разумное уточнение.
- Удаление — это пересборка. funes работает только на дозапись. «Забудь этот диалог» означает удаление исходного файла и переиндексацию директории этого пользователя. Для одного пользователя это дёшево, но всё равно остаётся явной операцией, нужной для запросов о приватности и политик хранения.
- Секреты и персональные данные остаются. Всё, что пользователь вставляет в чат, попадает в его память. Маскируйте на шлюзе перед пересылкой и заранее решите вопрос хранения. (У funes есть команда
scrubдля секретов, но не для бизнес-данных.) - Эмбеддинги в первую очередь под английский. bge-small-en — английская модель. BM25 по-прежнему точно находит коды на любом языке, но для смыслового поиска на других языках нужен многоязычный эмбеддер.
- Поведение агента непостоянно. Без явного упоминания имени инструмента в запросе агенту приходится самому решать, оглядываться ли назад. Хорошее описание инструмента доводит дело почти до конца. Строка в системном промпте («если пользователь ссылается на более раннюю работу, сначала вспомни, а потом отвечай») добирает остальное.
- Один процесс на вызов. Просто и надёжно, но каждое вспоминание платит за старт процесса и загрузку модели (часть тех самых ~0,2 с). При очень высокой частоте запросов долгоживущий MCP-сервер funes на арендатора (
funes mcp <memory>) позволил бы этого избежать.
Итог
Агентам не нужна пересадка мозга, чтобы перестать начинать с нуля. Им нужен способ заглянуть в то, что уже произошло. Когда поиск делает funes, вся фича сводится к одному маршруту, сохраняющему завершённые реплики, одному инструменту, который ищет по ним под личностью вызывающего, и одному контейнеру с закреплённым бинарником и запечённой моделью. Это не память в фантастическом смысле. Это вспоминание: датированные, проверяемые подсказки из прошлого, которые агент запрашивает, когда они нужны. Для людей, использующих агента, это разница между «напомни мне, что такое N-11» и «вы решили продолжать после закрытия MT-4471; он всё ещё не закрыт».
Полное демо (сервер, Dockerfile, compose-файл, затравочные диалоги, обёртка для агента и бенчмарк) — в сопутствующем репозитории.