Однажды в понедельник наш облачный поисковый сервис отключили, без даты возврата. На нём держались два инструмента нашего агента: один находит нужную таблицу базы данных по вопросу, другой ищет по документации продукта. Без них агент всё равно отвечал, но отвечал по памяти — а именно это инструмент документации должен предотвращать.
У нас было два варианта: подождать или построить локальную замену. Мы построили её за один день. Она работает как маленький контейнер рядом с сервером инструментов агента, не требует облачного аккаунта и запускается примерно за секунду. Через день облачный индекс вернулся, и мы наконец смогли сделать то, что откладывали: прогнать оба на одних и тех же вопросах и посмотреть, насколько они расходятся.
Эта статья продолжает нашу серию об инструментах для агентов через MCP. Первая дала агенту песочницу для Python, вторая передавала данные по ссылке, третья опробовала маленькую модель принятия решений для поиска таблиц, а четвёртая дала агенту возможность искать по прошлым чатам. Та статья использовала funes, который хранит свой индекс в формате Lance. Здесь Lance возвращается.
Что должен заменить «локальный RAG»
Управляемый поисковый сервис делает за вас четыре вещи:
- Поиск по ключевым словам (BM25) со стеммингом и весами полей.
- Векторный поиск с моделью эмбеддингов, которую сервис вызывает за вас при индексации и при запросе.
- Слияние двух списков (гибридный поиск) и, опционально, реранкер сверху.
- Эксплуатация: хранение, масштабирование, API, ключи.
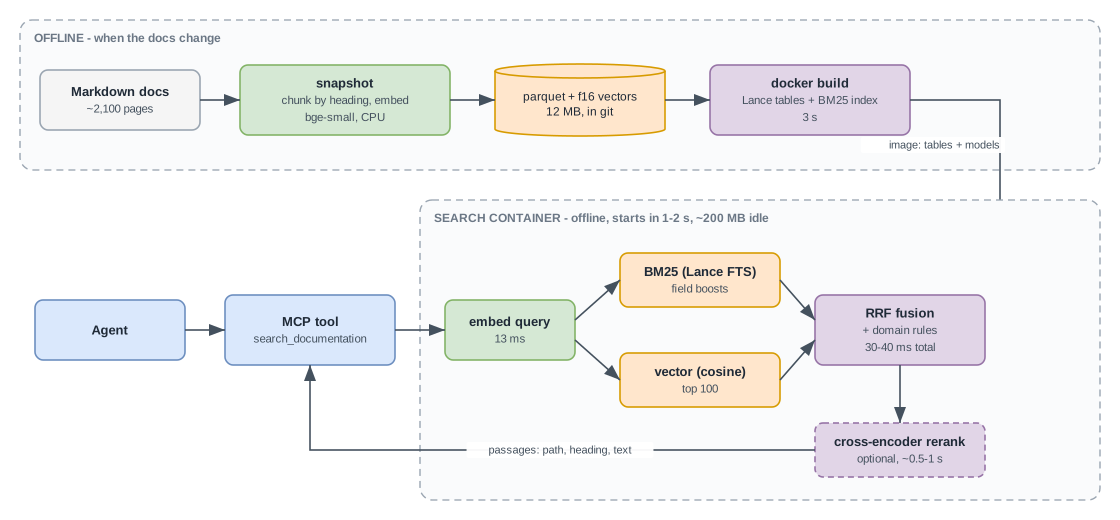
Первые три укладываются в один Python-процесс. Четвёртая по большей части не нужна, когда корпус — это несколько тысяч документов, которые меняются с каждым релизом, а не каждую минуту. Наша документация — это около 2100 страниц в Markdown (справка по экранам, технические заметки, инструкции, заметки о релизах), что превращается в 9000 фрагментов. Это немного. С этим справляется CPU ноутбука.
Стек
| Задача | Выбор | Почему |
|---|---|---|
| Хранение, BM25, векторный поиск | LanceDB 0.41 | одна встроенная библиотека делает оба вида поиска, файлы на диске, без сервера |
| Эмбеддинги | BAAI/bge-small-en-v1.5 через fastembed | 384 измерения, ONNX на CPU, 33 млн параметров |
| Реранкер (опционально) | jinaai/jina-reranker-v1-turbo-en через fastembed | маленький кросс-энкодер, тоже на CPU |
| Интерфейс для агента | инструмент MCP (FastMCP) или простой HTTP-маршрут | что угодно, что ваш агент уже умеет вызывать |
Никакого GPU, никакого API моделей, никакого сервера векторной базы данных. Модели скачиваются один раз при сборке образа, и контейнер работает офлайн.
Шаг 1: нарезка на чанки и индексация
Разрезайте каждую страницу по заголовкам ##/### и храните путь заголовков вместе с фрагментом. Чанки, выровненные по заголовкам, лучше чанков фиксированного размера, потому что разделы страницы справки обычно отвечают на один вопрос каждый, а заголовок — лучшее резюме, которое дал автор.
def chunks(root, max_chars=1600):
    for path in sorted(Path(root).rglob("*.md")):
        text = path.read_text(errors="ignore")
        title = next(iter(re.findall(r"^# (.+)$", text, re.M)), path.stem)
        for section in re.split(r"\n(?=#{2,3} )", text):
            heading = section.splitlines()[0].lstrip("# ").strip() if section.startswith("#") else ""
            for i in range(0, len(section), max_chars):
                yield {"path": str(path.relative_to(root)), "title": title, "heading": heading, "text": section[i:i + max_chars]}


def build(root, data_dir):
    rows = list(chunks(root))
    embedder = TextEmbedding("BAAI/bge-small-en-v1.5")
    vectors = embedder.embed([f"{r['title']} > {r['heading']}\n{r['text']}" for r in rows], batch_size=64)
    for r, v in zip(rows, vectors):
        r["vector"] = v.tolist()
    table = lancedb.connect(data_dir).create_table("docs", data=rows, mode="overwrite")
    table.create_fts_index("text", use_tantivy=False, language="English", stem=True, remove_stop_words=True)
Эмбеддите заголовок страницы и заголовок раздела вместе с текстом. Фрагмент «Нажмите Insert, чтобы добавить запись» ничего не значит без «Простои оборудования > Ввод событий» над ним.
Шаг 2: гибридный поиск с reciprocal rank fusion
Запустите оба поиска, затем объедините их по рангу, а не по оценке. Оценки BM25 и косинусные расстояния живут в разных масштабах, и reciprocal rank fusion (RRF) позволяет не калибровать их: каждый список даёт документу 1 / (60 + rank), а решают суммы.
def search(self, query, k=5):
    vec = next(iter(self.embedder.embed([QUERY_PREFIX + query])))
    keyword = self.table.search(query, query_type="fts").with_row_id(True).limit(50).to_list()
    semantic = self.table.search(vec).distance_type("cosine").with_row_id(True).limit(50).to_list()
    scores, rows = {}, {}
    for hits in (keyword, semantic):
        for rank, r in enumerate(hits):
            scores[r["_rowid"]] = scores.get(r["_rowid"], 0) + 1 / (60 + rank + 1)
            rows[r["_rowid"]] = r
    top = [rows[i] for i in sorted(scores, key=scores.get, reverse=True)[:max(k, 10)]]
    if self.reranker:
        ce = list(self.reranker.rerank(query, [f"{r['title']} > {r['heading']}\n{r['text'][:1000]}" for r in top]))
        top = [r for _, r in sorted(zip(ce, top), key=lambda p: -p[0])]
    return top[:k]
QUERY_PREFIX — это инструкция, с которой модели bge были обучены на стороне запроса («Represent this sentence for searching relevant passages: »). Фрагменты эмбеддятся без неё.
Шаг 3: предоставить это как инструмент
mcp = FastMCP("local-docs")

@mcp.tool
def search_documentation(query: str, k: int = 5) -> list[dict]:
    """Search the product documentation. Returns passages with file path and heading; cite the path."""
    return search(query, min(k, 10))

mcp.run(transport="http", host="0.0.0.0", port=8080)
Это вся обобщённая версия: около 90 строк, протестированная на выборке из 300 страниц (686 фрагментов проиндексированы за 70 с на ноутбуке, 0,5–0,7 с на вызов инструмента при включённом реранкере).
Шаг 4: часть, специфичная именно для вас
Обобщённый конвейер проводит вас большую часть пути. Остальное взялось не из библиотеки, а из набора для оценки. В нашей продакшен-версии числа изменили следующие вещи:
- У структурированных полей свои собственные веса. BM25 работает по нескольким полям:
title×3, имя и код страницы ×3,headings×2,text×1. - Коды в запросе — точные сигналы. Когда вопрос называет код страницы (
MT.0020), собственная страница справки этого кода закрепляется на первом месте. Эмбеддинги смазывают коды; фильтр — нет. - Руководства побеждают заметки о релизах, если вопрос не спрашивает о версии или релизе. Заметки о релизах упоминают всё и не объясняют ничего.
- Не больше двух фрагментов на страницу, чтобы одна длинная страница не заполнила весь список результатов.
- Популярность как априорная вероятность (для инструмента поиска таблиц): таблица, которую упоминают многие другие описания таблиц, вероятнее окажется ответом, чем малоизвестное представление с похожим именем. Именно эта единственная априорная вероятность дала там наш самый большой выигрыш.
Каждое из этих правил — строка или две кода подсчёта оценки, настроенная по фиксированному набору вопросов (hit@k, MRR) и перезапускаемая после каждого изменения. Без этого набора мы настраивали бы всё на глазок.
Шаг 5: сделать запуск скучным
Эмбеддинг 9000 фрагментов занимает около 22 минут на CPU ноутбука, так что контейнер никогда не должен делать это при запуске. Мы разбили конвейер на три этапа:
| Этап | Когда | Стоимость |
|---|---|---|
snapshot: корпус → parquet со строками и векторами float16 | когда меняются документы; результат коммитится | полный прогон около 25 мин на ноутбуке, минуты на многоядерной машине; неизменившиеся фрагменты переиспользуют свои векторы (по ключу — хэшу имени модели и текста) |
build: parquet → таблицы Lance и полнотекстовые индексы | docker build | 3 с |
serve: открыть таблицы, загрузить модели | запуск контейнера | 1–2 с |
Оба корпуса (документация и описания таблиц) вместе дают снапшот parquet на 12 МБ. Модели запечены в образ, контейнер работает с HF_HUB_OFFLINE=1 и готов за 4 с при выключенной сети. Простаивающая память — около 200 МБ.
Сравнение, которое раньше было невозможно
Когда облачный индекс вернулся, мы прогнали обе системы на 15 вопросах по документации из нашего набора для оценки агента. У каждого вопроса есть набор эталонных кодов страниц: страниц, которые правильный ответ обязан процитировать. Результат считается попаданием на ранге n, если n-й фрагмент принадлежит одной из этих страниц или называет её. Оба индекса построены из одной и той же базы знаний в Markdown.
На облачной стороне мы попробовали три режима на одном и том же индексе: только ключевые слова, гибридный (ключевые слова плюс векторы text-embedding-3-small, 1536 измерений) и гибридный с семантическим реранкером сервиса. Каждый вопрос задавался дважды: как короткий поисковый запрос, который написал бы агент, и как исходный вопрос пользователя.
Запросы в стиле агента (например, «equipment downtime registration screen»):
| Система | hit@1 | hit@5 | MRR | задержка p50 |
|---|---|---|---|---|
| Локально: гибрид + реранк | 0,60 | 0,87 | 0,71 | 0,99 с |
| Локально: гибрид, без реранка | 0,60 | 0,80 | 0,70 | 0,03 с |
| Облако: ключевые слова | 0,40 | 0,80 | 0,57 | 0,87 с |
| Облако: гибрид | 0,67 | 1,00 | 0,81 | 1,10 с |
| Облако: гибрид + семантический реранк | 0,53 | 0,80 | 0,67 | 1,18 с |
Исходные вопросы пользователя (например, «How is equipment downtime registered? Is it the same as a planned outage, and where do I record it?»):
| Система | hit@1 | hit@5 | MRR | задержка p50 |
|---|---|---|---|---|
| Локально: гибрид + реранк | 0,47 | 0,87 | 0,64 | 1,11 с |
| Локально: гибрид, без реранка | 0,47 | 0,80 | 0,57 | 0,04 с |
| Облако: ключевые слова | 0,27 | 0,67 | 0,47 | 0,92 с |
| Облако: гибрид | 0,47 | 0,93 | 0,63 | 1,17 с |
| Облако: гибрид + семантический реранк | 0,53 | 0,73 | 0,61 | 1,31 с |
Как это читать:
- Облачный гибрид — лучшая система на чистых запросах. Он нашёл эталонную страницу в топ-5 для всех 15. Здесь проявляется его более крупная модель эмбеддингов, особенно на коротких запросах с малым пересечением по словам.
- На исходных вопросах обе системы на одном уровне (MRR 0,64 против 0,63). Длинным, разговорным вопросам нужен реранкер; без него локальный MRR падает до 0,57.
- Поиск только по ключевым словам явно хуже с обеих сторон. Если ваш «локальный RAG» — это только BM25, вы теряете 15–25 пунктов MRR.
- Семантический реранкер облака не помог на этом наборе. Он поднял некоторые эталонные страницы на первое место, но вытолкнул другие из топ-5. Измеряйте, прежде чем платить за это.
- Пятнадцать вопросов — маленькая выборка. Один вопрос двигает hit@k на 0,067. Считайте различия меньше 0,1 шумом. На полном наборе из 69 вопросов по документации локальный движок даёт hit@5 0,83, MRR 0,64 — согласуется с цифрами выше.
Поиск таблиц: где окупаются доменные правила
Второй инструмент сопоставляет вопрос с одним из примерно 3300 описаний таблиц. В облачном индексе те же описания (3298 документов, векторы text-embedding-3-small, семантическая настройка). Та же процедура: 15 вопросов из набора, эталон — таблицы, которые использует правильный ответ.
| Система | Запрос агента: hit@1 | hit@5 | MRR | Исходный вопрос: hit@1 | hit@5 | MRR |
|---|---|---|---|---|---|---|
| Локально: гибрид + априорные + реранк | 0,53 | 0,87 | 0,67 | 0,67 | 0,80 | 0,72 |
| Облако: ключевые слова | 0,27 | 0,33 | 0,33 | 0,13 | 0,40 | 0,26 |
| Облако: гибрид | 0,27 | 0,53 | 0,40 | 0,27 | 0,73 | 0,49 |
| Облако: гибрид + семантический реранк | 0,47 | 0,87 | 0,62 | 0,33 | 0,73 | 0,49 |
Здесь картина переворачивается. Имена таблиц — это плотные аббревиатуры, и многие таблицы делят между собой большинство слов («дневные итоги по площадке», «месячные итоги по площадке», доступная только для чтения дневная сводка того же самого). Обобщённая релевантность не может их разделить, а априорная вероятность по популярности, сигнал временного масштаба («дневной», «месячный») и раскрытие аббревиатур в именах — могут. Семантический реранкер облака окупает свою стоимость на этом индексе (MRR 0,40 → 0,62 на запросах агента), но на исходных вопросах всё равно сильно отстаёт.
Одна честная оговорка насчёт обоих инструментов: локальные веса были настроены на том же наборе, из которого взяты эти 15 вопросов. Это преимущество «в рамках выборки», которого нет у облачного индекса. Больше всего это важно для поиска таблиц, где правила наиболее специфичны. Читайте разрыв в поиске таблиц как «доменные правила стоят многого», а не как «локальный движок в целом лучше».
Насколько это быстро?
| Шаг | Медиана |
|---|---|
| Эмбеддинг запроса (bge-small) | 13 мс |
| BM25 + векторный поиск, топ-100 каждый | 30–40 мс |
| Реранк кросс-энкодером, 20 фрагментов | ~1000 мс |
| Реранк кросс-энкодером, 10 фрагментов | ~500 мс |
Поиск сам по себе практически бесплатен — время уходит на реранкер. Реранк 10 фрагментов вместо 20 сократил стоимость вдвое без изменений на запросах в стиле агента (MRR 0,71 в обоих случаях) и с небольшой потерей на исходных вопросах (0,64 → 0,61). Если ваш агент пишет хорошие поисковые запросы — а описание инструмента может это требовать — можно выключить реранкер и отвечать за ~40 мс.
Облачные цифры включают сетевой путь туда-обратно от ноутбука в Европе до региона в США и, в гибридном режиме, собственный вызов сервисом модели эмбеддингов. В том же регионе они были бы ниже. В локальных цифрах сетевого перехода нет вовсе.
Плюсы и минусы
| Локально | Облачный поисковый сервис |
|---|---|
| Нет аккаунта, нет ключей, нет исходящего трафика: документы не покидают машину | Управляется провайдером: масштабирование, доступность, проверки безопасности — не ваша забота |
| Индекс — это файл: версионируется вместе с кодом, воспроизводим, поддаётся diff | Индекс живёт в сервисе; пересборка — это пайплайн, а не коммит |
| Любое правило ранжирования можно менять и тестировать (поиск таблиц: MRR 0,72 против 0,49 на исходных вопросах) | Ручки ранжирования ограничены тем, что открывает сервис |
| 30–40 мс без реранка | Из коробки доступны более крупные модели эмбеддингов |
| Работает в air-gapped и клиентских инсталляциях | Справляется с миллионами документов и частыми обновлениями |
| Вы сами владеете настройкой, обновлением моделей и набором для оценки | Лучшее качество с первой попытки на коротких, общих запросах (документация: MRR 0,81 против 0,71) |
| Образ на ~2 ГБ с моделями и рантаймом; реранкер нагружает CPU | Постоянный ежемесячный счёт за единицу поиска плюс вызовы эмбеддингов |
Чего ожидать, если вы это сделаете
- День первый: обобщённый конвейер выше, контейнер и инструменты агента, переключённые на него. Агент снова цитирует настоящие страницы.
- День второй: набор из 50–100 реальных вопросов с известными ответами и доменные правила из шага 4. Здесь вы приближаетесь к гибридному режиму облака.
- Постоянно: перезапускайте
snapshot, когда меняется документация, и перезапускайте оценку каждый раз, когда трогаете вес. Смена модели эмбеддингов означает переэмбеддинг всего, так что выберите одну и держитесь её. - Не подходит для: корпусов, которые меняются каждую минуту, миллионов документов или множества языков (bge-small — английская модель; есть многоязычные модели, но сначала оцените их).
Ограничения
- Размер эмбеддинга важен на коротких запросах. 384-мерная модель на CPU дешёвая и хорошая, но не такая хорошая, как 1536-мерная модель через API, на коротких запросах с малым пересечением слов. Доменные правила и реранкер закрывают большую часть разрыва, но не убирают его целиком.
- Кросс-энкодер — это налог на CPU. Около секунды на 20 фрагментов. Закладывайте это в размер контейнера или ограничивайте его длинными вопросами.
- Набор для оценки — это и есть продукт. Каждая цифра в этой статье взялась из набора вопросов, который кто-то должен был написать и оценить. Без него нельзя понять, помогло ли изменение, и нечего с чем сравнивать.
- Настроено внутри выборки. Наши веса взялись из того же набора вопросов, что и сравнение. Для честного реванша нужен отложенный набор, написанный после настройки.
Итог
Облачный поисковый индекс удобен, но не незаменим. Для корпуса из нескольких тысяч документов встроенный движок с BM25 и векторами, маленькая модель эмбеддингов на CPU и reciprocal rank fusion дают рабочую замену за один день. С парой доменных правил и реранкером результат укладывается в шум по сравнению с гибридным режимом облака на вопросах по документации, немного отстаёт на чистых коротких запросах и уверенно опережает на поиске таблиц, где всю работу делают доменные правила. В обмен на это индекс становится файлом в вашем репозитории, ранжирование — кодом, который можно тестировать, и ничего не покидает машину. Конвейер — это лёгкая часть. Первое, что мы построили бы в следующий раз, — это набор вопросов.